做数据采集的人多半有过这种早上:脚本跑了三个月一直好好的,某天打开导出的表发现是空的。去对方站上一看,栏目没变、内容没少,只是 .product-card 被改成了 .item-listing,你的选择器一夜之间就失效了。
这类故障不是你写得不认真,是硬编码选择器这套机制本身就脆。Scrapling 想改掉的就是这一层。
是什么
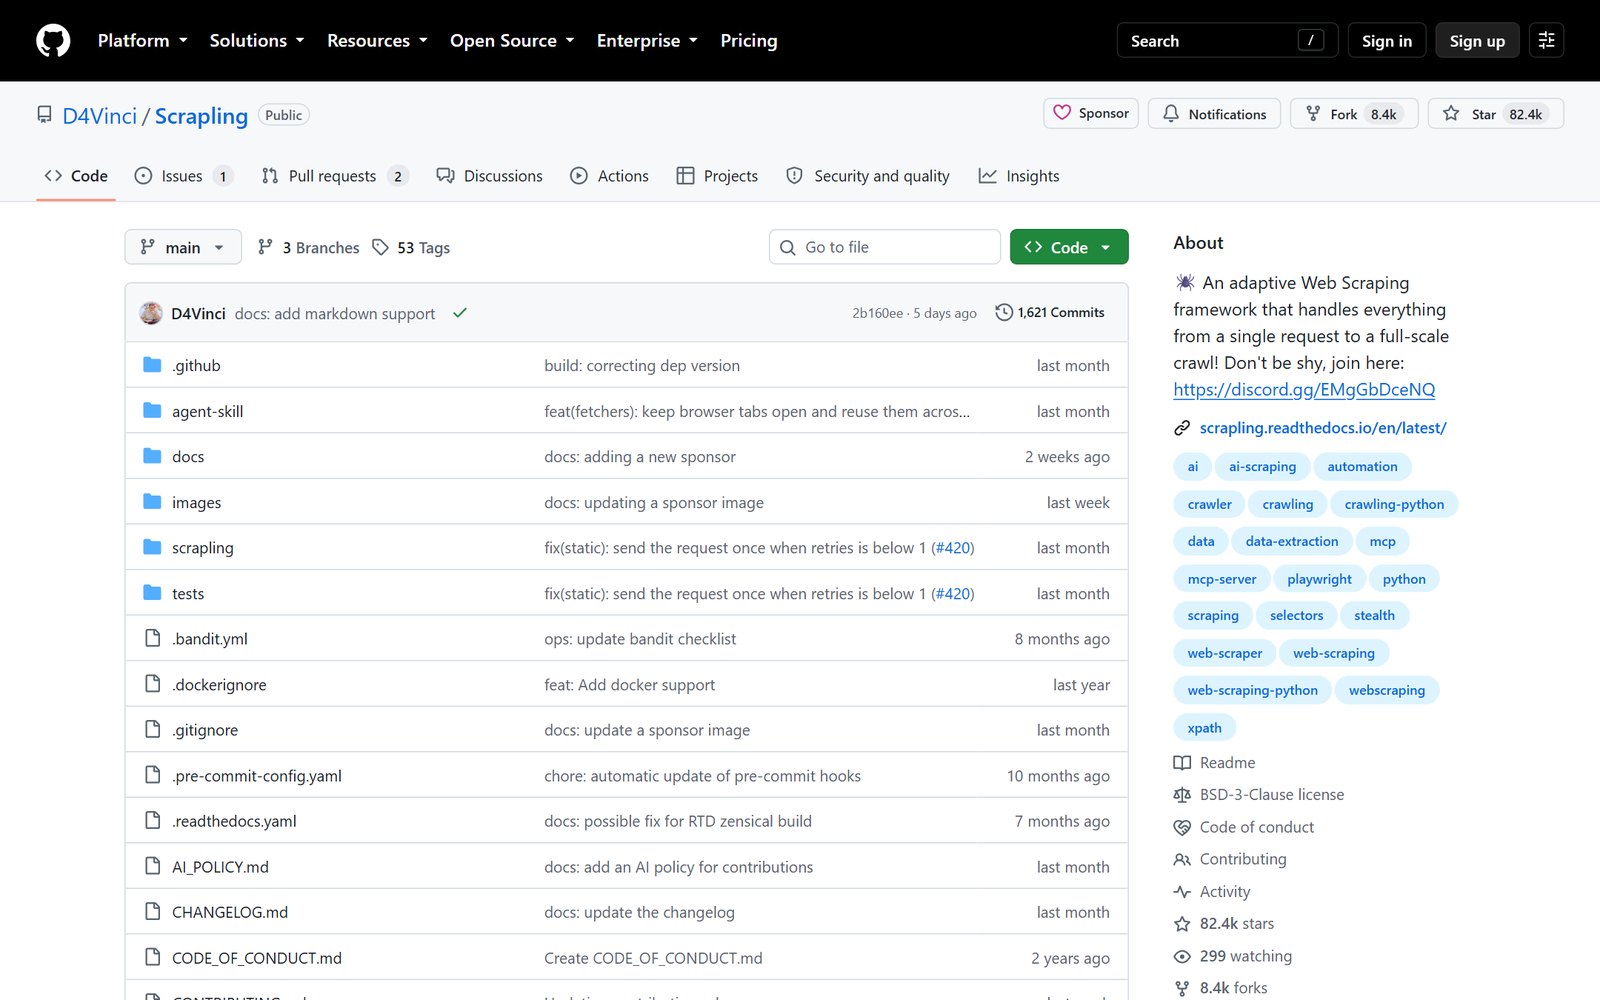
它是 Python 写的自适应网页采集框架,BSD-3 协议。三块能力拼在一起:一套"能记住元素长相"的解析器、四种抓取方式(普通 HTTP、异步、无头浏览器、隐身浏览器)、一个 Scrapy 风格的爬虫框架。仓库 8.2 万 Star、8397 Fork,当前版本 v0.4.15,9 月中旬还有提交。有意思的是它只有 3 个 open issue,这个数字反而说明维护者在积极清账。
核心优势
选择器能自愈,这是它跟同类最不一样的地方。首次抓取的时候传 auto_save=True,它会给你选中的元素录一份结构指纹存下来;站点改版之后传 adaptive=True,它按相似度算法把同一批逻辑元素重新找回来。类名变了、嵌套层级变了、周围标记全换了,它也认得出。整个过程不用调大模型,是纯算法的结构比对,所以离线能跑、速度也不受模型影响。
解析速度摆得出对照。项目自测 5000 个嵌套元素、跑一百次以上取平均:Scrapling 2.02 毫秒,Parsel/Scrapy 2.04 毫秒,裸 lxml 2.54 毫秒,PyQuery 24.17 毫秒,BeautifulSoup 配 lxml 解析器 1584.31 毫秒。JSON 序列化比标准库快约 10 倍。相似元素查找 2.39 毫秒对 AutoScraper 的 12.45 毫秒。也就是说解析这件事在它这里基本不是瓶颈了,瓶颈回到网络本身。
抓取按难度分三层,一个 API 全含。Fetcher 走普通请求但会伪装浏览器 TLS 指纹、支持 HTTP/3;DynamicFetcher 起无头浏览器,可以接 Playwright 的 Chromium 或者你自己的 Chrome;StealthyFetcher 做指纹伪装并处理 Cloudflare 的 Turnstile 和拦截页。三档都有对应的 Session 类来持久化 cookie 和状态,同一个抓取任务里可以按 session id 把不同链接路由到不同档位。另外内置 ProxyRotator(循环或自定义策略,也能按请求临时换代理)、可选的 DNS over HTTPS 防泄漏、以及约 3500 个广告和追踪域名的拦截表。
爬虫框架该有的都补齐了。并发上限、按域名限速、被拦自动检测并重试(重试逻辑可换);Ctrl+C 优雅暂停、带上同一个 crawldir 重启就从中断处续爬;async for item in spider.stream() 边爬边流式拿结果,适合接 UI 或者长跑任务。它还有个 AutoThrottle:按目标站点的响应速度自己调每个域名的延迟,一旦被限流或封就翻倍(或者听对方 Retry-After 的),恢复正常再提速。比手写固定 sleep 靠谱。现成模板覆盖 CrawlSpider(按规则跟链接)、SitemapSpider、XMLFeedSpider / CSVFeedSpider,以及 ShopifySpider,能从任何 Shopify 店的 JSON 接口把整店商品按变体拉成一条一条记录。开发模式会把响应缓存到本地重放,改 parse() 逻辑时不用反复去打对方服务器。
给 AI Agent 用的那部分做得挺讲究。它自带 MCP 服务,给 Claude、Cursor 这类宿主提供一次性或会话式的抓取工具:纯 HTTP 任意方法、浏览器抓取、过 Cloudflare 的隐身抓取、截图、通过 CDP 连远程浏览器。关键设计是它先用 CSS 选择器把页面裁窄,并在交给模型之前剥掉提示注入内容。模型读得少、花得少,也不容易被页面里的隐藏文字劫持。另外还有 page.markdown() 一行把任意页面转成干净的、LLM 可直接读的 Markdown,或者用 SiteToMarkdownSpider 把整站爬成一个 Markdown 语料库,全程不需要模型参与。
工程质量是能看见的。92% 测试覆盖、完整类型标注,PyRight 和 MyPy 每次改动都会扫一遍全库;作者 Karim Shoair 本人是长期做爬虫工具的人,README 后面那条引用格式就是给做研究的用户准备的。
怎么用
基础安装只要 pip install scrapling;要浏览器和隐身能力再装 pip install "scrapling[fetchers]",装完必须单独跑一次 scrapling install 把 Chromium 和 Firefox 拉下来。这一步漏了会在第一次调用浏览器抓取时报错。要 AI 和 Shell 能力就装 scrapling[ai]、scrapling[shell],或者一步到位的 scrapling[all]。官方也提供装齐了浏览器和全部扩展的 Docker 镜像。
写代码很短:
StealthyFetcher.fetch('https://example.com', headless=True, network_idle=True) 拿到页面对象,然后 page.css('.product', auto_save=True) 抓一次并记录指纹,站点改版之后改成 page.css('.product', adaptive=True) 让它自己重新定位。CSS、XPath、BeautifulSoup 风格的 find_all、文本搜索、正则搜索都挂在同一个 page 对象上,不用换库换写法。要爬多页就继承 Spider,写 start_urls 和异步的 parse,yield 字典,结束用 result.items.to_json(...) 导出。
不写代码也行,命令行能直接用:scrapling extract get 'https://example.com' output.md --css-selector '.content' --impersonate 'chrome',输出格式按文件后缀自动判断(.md 转 Markdown、.json 出 JSON)。遇到有反爬的站换成 extract stealthy-fetch 再加 --solve-cloudflare。它还有个基于 IPython 的交互式 Shell,能把 curl 命令直接转成 Scrapling 请求、在浏览器里看结果。
不是没有槽点
自适应不是万能药。它靠结构相似度打分,站点如果做了整体重构,不只是改类名,而是内容块的位置、层级、数量都翻了新,它也可能把元素找错或者找串。指纹存下来了,但结论该人工复核还是得复核,尤其在抓的是订单、价格这类不能错的字段时。
合规责任在你自己身上。项目在免责声明里写得很明确:仅供教育与研究用途,使用者要自行遵守当地法律和数据法规、尊重目标站点的服务条款和 robots.txt。而且 robots_txt_obey 是可选开关,默认不开,也就是说默认行为并不替你遵守 robots 协议,这一点得自己心里有数。
隐身抓取要付代价。走浏览器就绕不开资源占用和速度,真要在有风控的站点上长期稳定跑,代理基本是必需品,而 README 里那一大页赞助商写的都是代理服务——这个事实本身说明了维护成本落在哪。抗指纹对抗是持续军备竞赛,不是配一次就永久有效。
生态位有点夹在中间。纯解析比裸 lxml 慢一点点(2.02 对 2.54 毫秒,都是毫秒级,实际差不出体感);论大规模爬取的调度和中间件生态,Scrapy 多年的积累比它厚。它的价值集中在"自适应 + 反爬 + 一套 API 通吃"这三件事的组合上,单拆开看每一项都不是绝对优势。
环境要求不低。需要 Python 3.10 以上;带浏览器的 extras 装完还要单独下浏览器,在 CI 里这个额外步骤容易被忘掉;如果 CI 环境没有图形依赖,还得处理无头运行的那堆系统库。
跟同类怎么比
对 BeautifulSoup。定位本来就不同,BS4 是解析库,不负责抓取。但如果你现在用 BS4 加 requests 拼一套采集脚本,换成 Scrapling 能同时拿到更快的解析、内建的反爬和改版自愈,代码量反而更少。
对 Scrapy。Scrapy 的优势是成熟:调度器、中间件、扩展、社区沉淀都更厚,跑大项目更稳。代价是选择器写死的,站点改版就得改代码重新上线。Scrapling 提供 scrapling_response 装饰器,可以直接套在现有 Scrapy 的回调上,用它的解析器处理你已经抓到的响应,也就是说不用推翻现有项目,可以只借它的自适应能力。
对 Playwright 或 Selenium 自己写。自己写最灵活,但指纹伪装、代理轮换、限速退避、断点续爬、被拦检测这些都要自己实现一遍,而且每一条都是坑。Scrapling 把这些做成了默认行为,代价是多一层抽象,出问题时得先读它内部怎么决策的。
对商业采集 API。商业服务省运维、按量付费、有客服兜底,但要过第三方、受服务商策略影响、复杂场景经常要加钱升级。Scrapling 是自托管,前期要自己调,长期成本可控,数据不出自己的机器。
一句话判断:如果你的采集脚本长期跑、目标站点又在持续迭代,那"自适应"这一条就值得你迁移;如果只是一次性抓一批数据,用 requests 配 BS4 更快更省事。
项目地址:https://github.com/D4Vinci/Scrapling
官方文档:https://scrapling.readthedocs.io/en/latest/
标签:#Scrapling #网页采集 #Python #爬虫框架 #自适应选择器 #BSD3
你更怕站点改版把选择器弄失效,还是更怕 IP 被限流?