任务管理器只给一行「显存已用 15 GB」,然后就没有然后了。想查是谁占的,得在驱动面板、进程列表和模型加载日志之间来回翻,最后还是不知道该关哪一个。更让人困惑的是,显卡内存明明吃紧,系统内存也跟着涨了一截,这部分算谁的,没人说得清。跑本地模型的人对这一幕大概不陌生:数字很全,归因全靠猜。
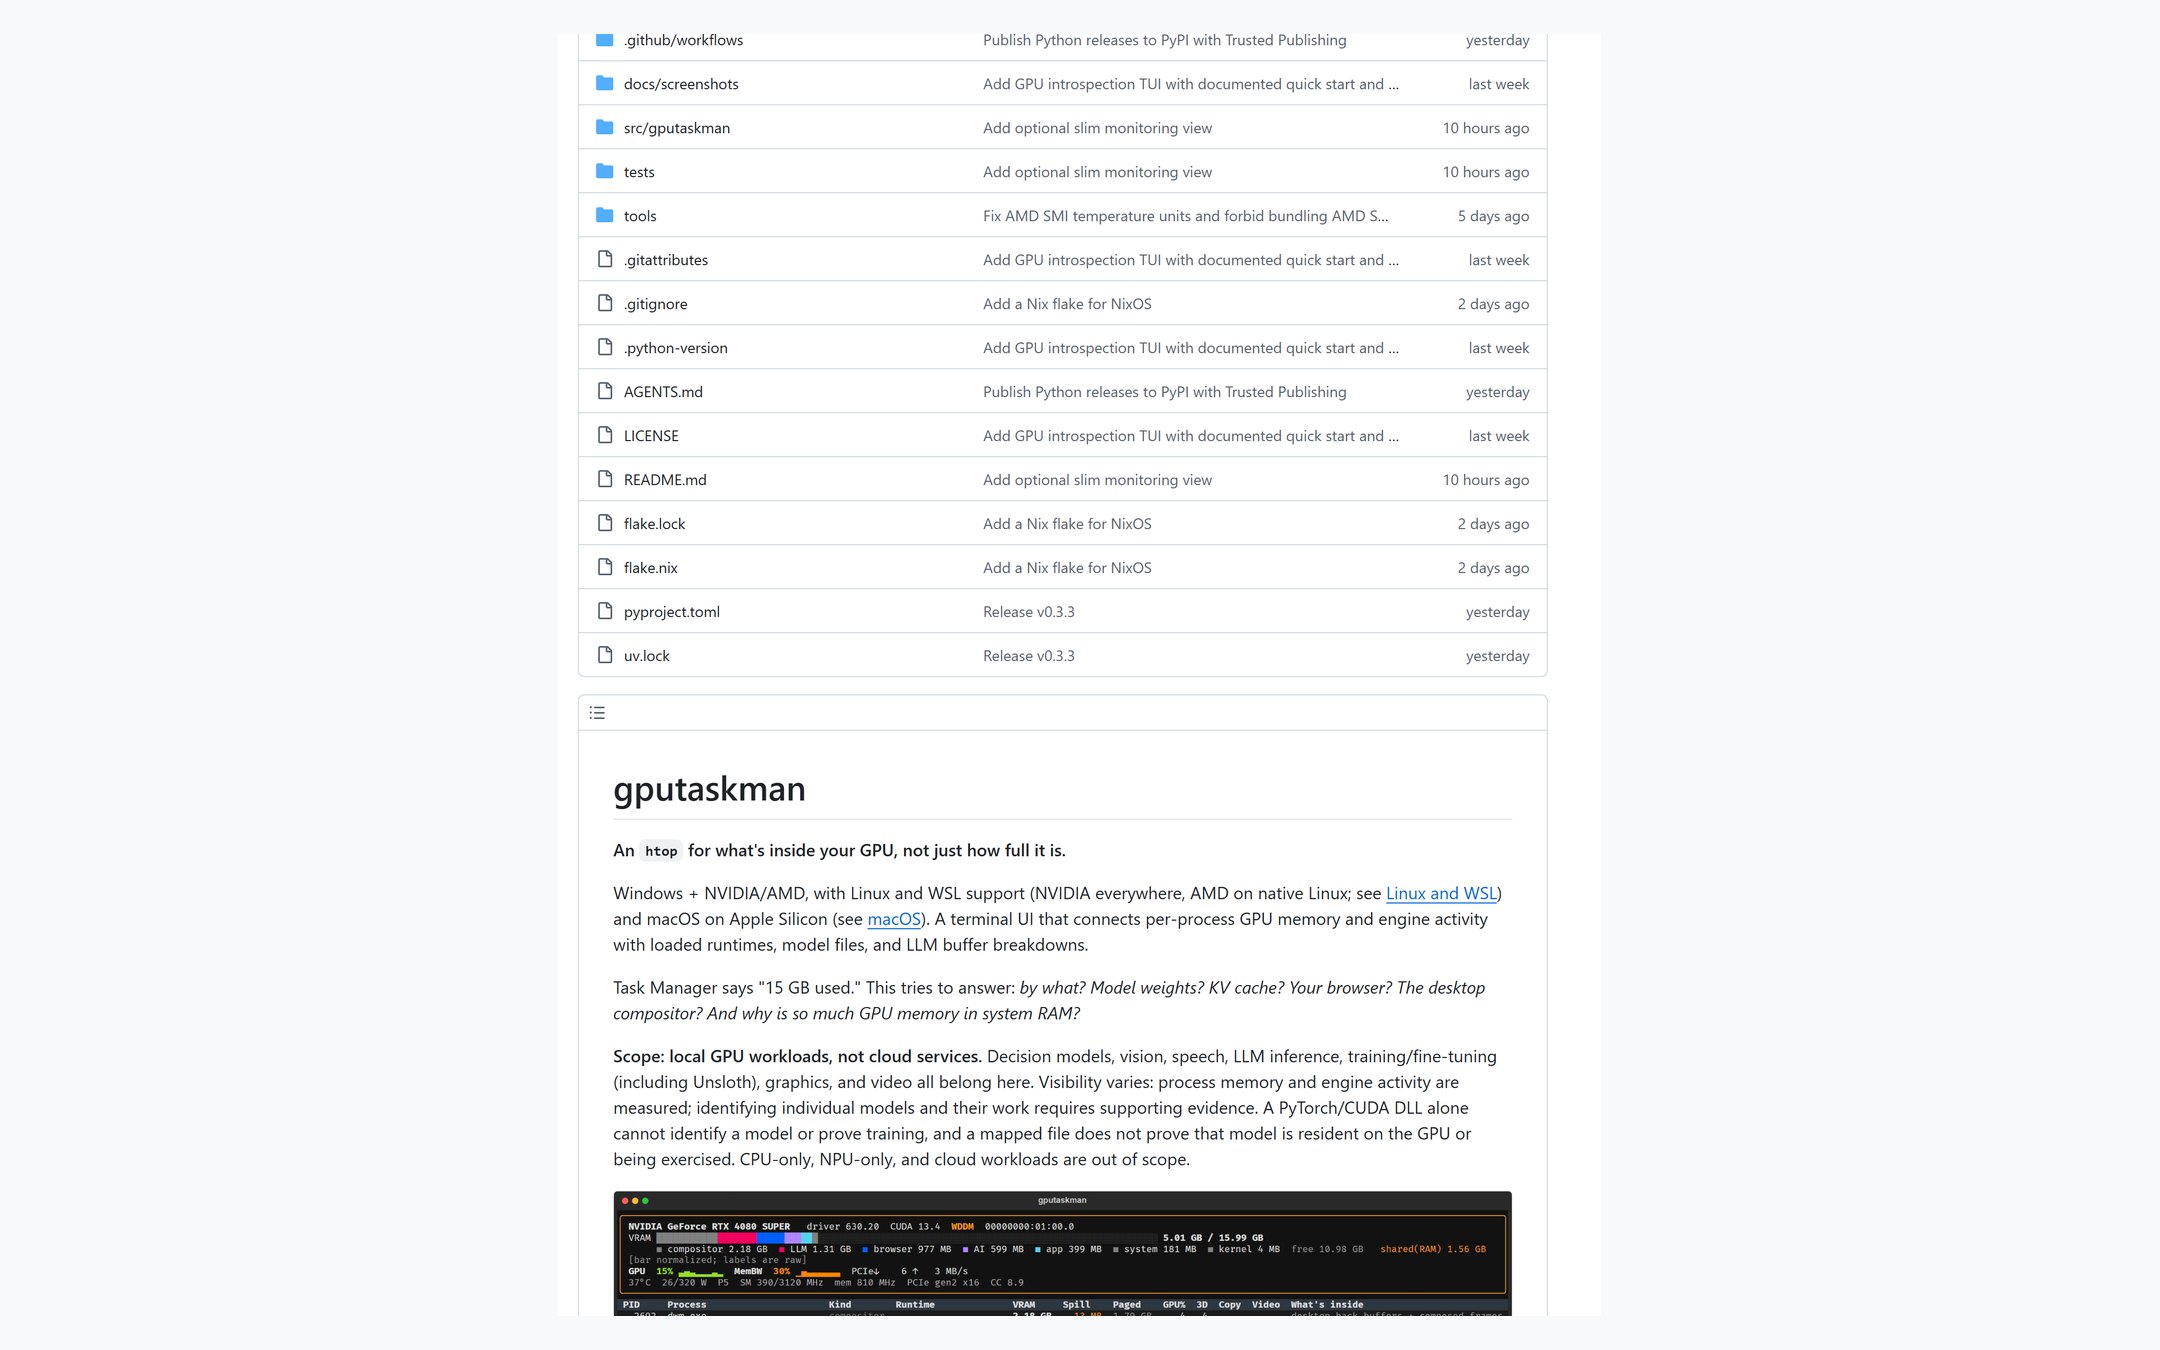
gputaskman 仓库首页,标题写着「给显卡里装了什么看个明白」
gputaskman 是 11 月 3 日新建的开源仓库,到 11 月 9 日攒了 728 颗星,Python 编写,采用 MIT 许可,当前版本 0.3.3。它做的不是又一个仪表盘,而是一个终端界面:把每个进程的显存占用与显卡各引擎的活动,和已加载的运行时、模型文件,以及大模型的权重、键值缓存、计算缓冲区逐项对起来。官方那句自述说得很直白——任务管理器告诉你「用了 15 GB」,它想回答的是「被什么用了」。支持范围写得清楚:Windows 上的 N 卡和 A 卡,Linux 与 WSL 下的 N 卡(A 卡只在原生 Linux 上可用),以及苹果芯片的 Mac。
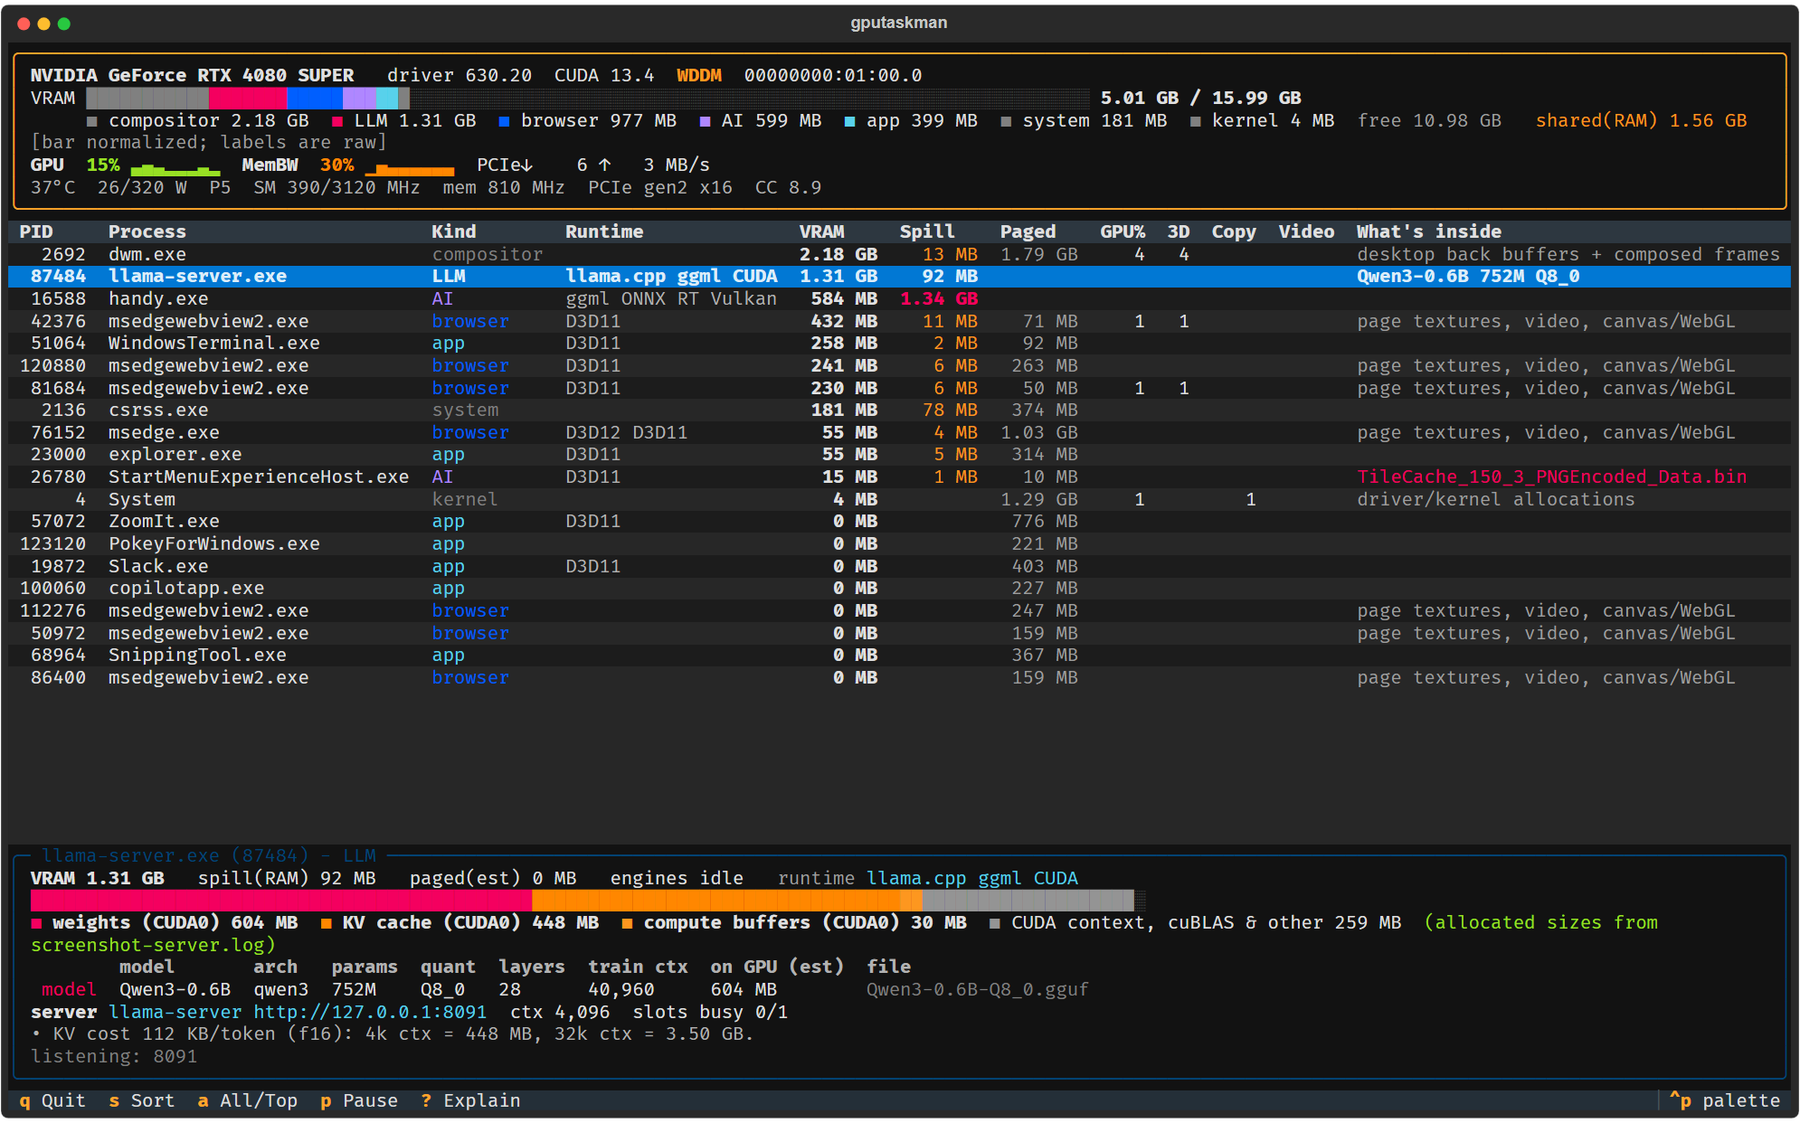
实时总览界面,进程列表旁标出模型权重、键值缓存与计算缓冲区
安装门槛压得低。会用包管理的话一行命令装完就能跑,也可以用打包好的便携压缩包,解压后直接运行,不需要额外准备 Python、编译工具、管理员权限,也不用申请密钥或下载模型。项目把边界划得很实在:只看本机显卡上的负载,云端任务、纯处理器和纯神经网络处理器的活儿都不在范围内;进程显存和引擎活动是量出来的,模型识别与缓冲区拆分是有依据的估算,它不导出显存内容,也不去枚举游戏的贴图。
第一,它补的是「按进程归因」这一层。总量、负载、温度、功耗这些读数,原来的工具大多也有;真正缺的是把「15 GB」拆成哪个进程、哪一类用途,桌面合成器、浏览器、正在跑的推理服务各占多少,摆在一张表里,该关谁就不用赌。说明里甚至专门写了,仅凭一个深度学习动态库不能认定在训练模型,一个被映射的文件也不等于模型真的驻留在显卡上——愿意把不确定的地方标成不确定,比多给一个漂亮数字可信。
第二,跨平台这件事上,它选择把差异摊开而不是抹平。原生 Linux 能读到每进程显存与各引擎负载;WSL 里的每进程数据要从宿主机匹配过来,界面会用星号或问号标出来源;关掉互操作之后,那一列干脆显示不适用。页面会写明当前处于哪种模式,而不是让三套系统看起来一样全。代价也一目了然:版本还在 0.3,作者自己标了「早期实验软件」,便携版尚未代码签名,首次运行会看到系统提示。
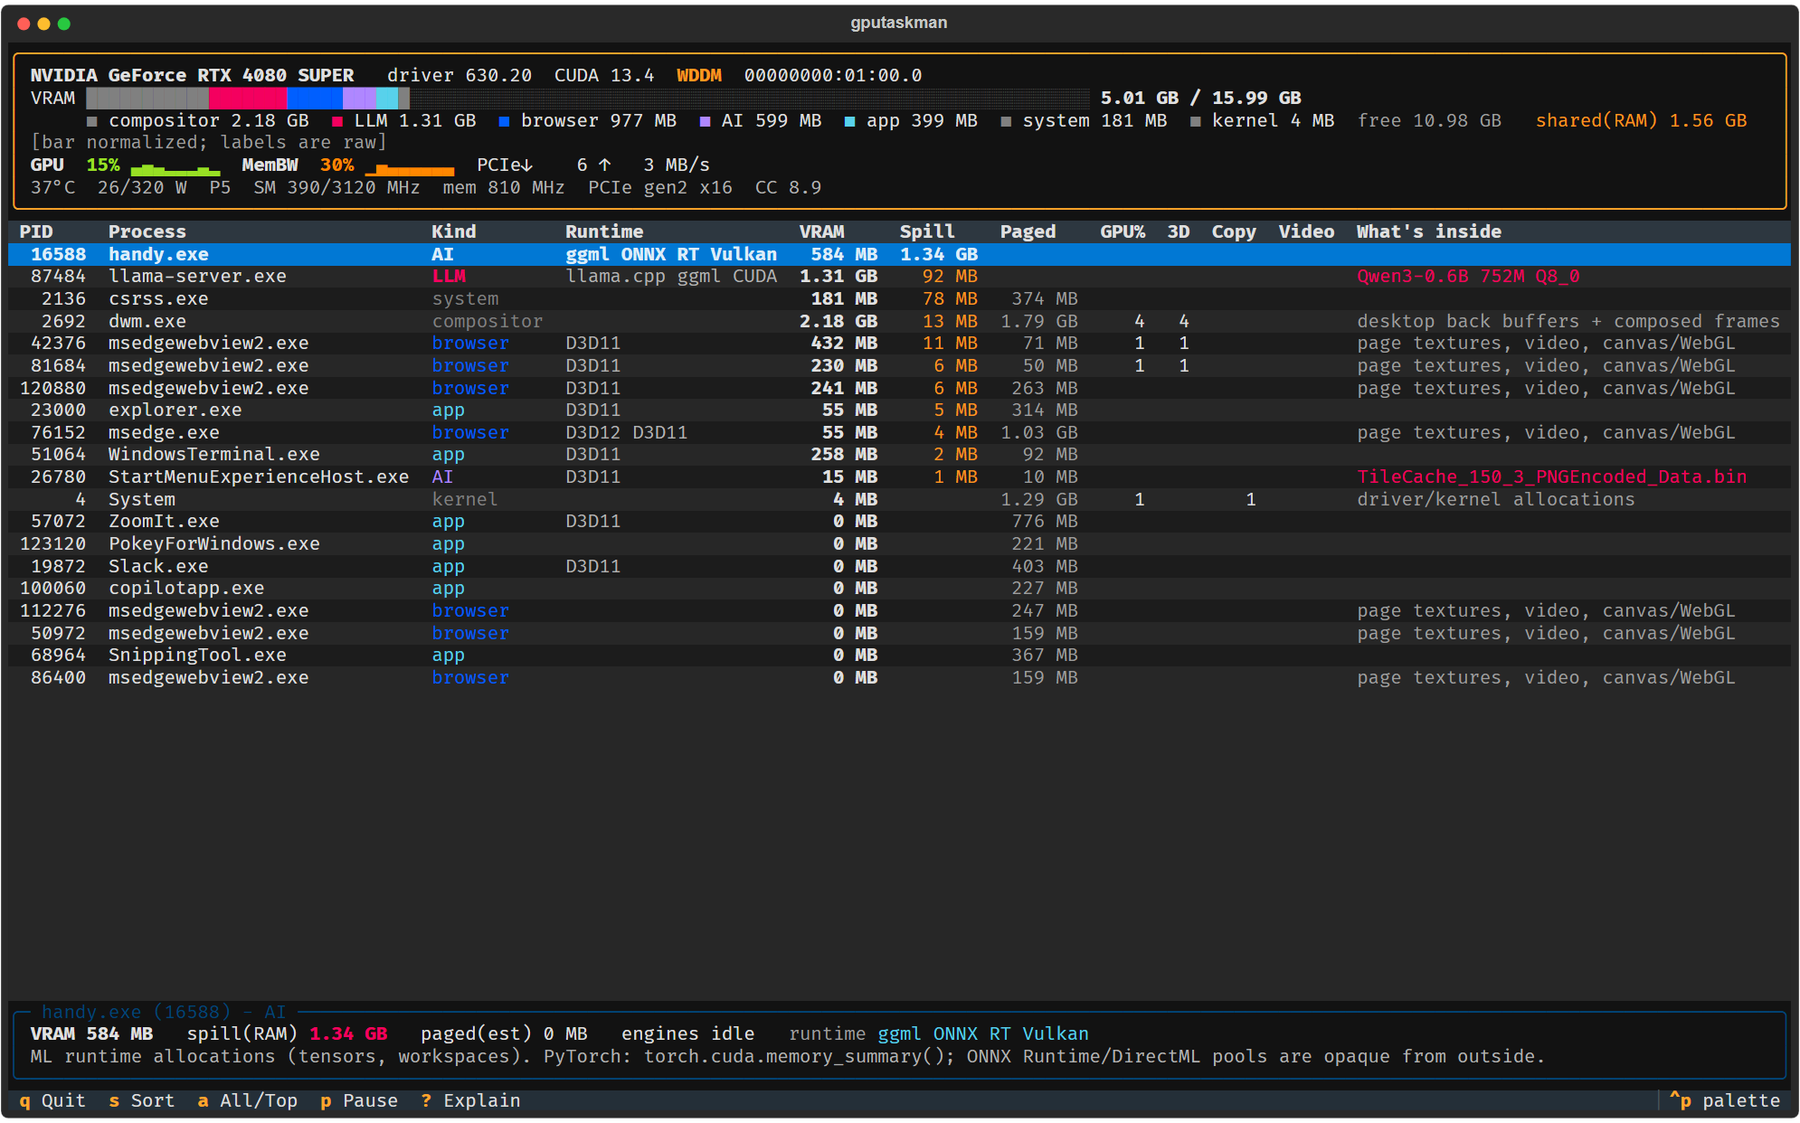
系统内存视图,显存溢出到内存的部分被单独列出
第三,别把它当成能替你做决定的成品。它给的是证据链,不是优化建议:看到某个进程占了 1.31 GB,还得自己判断是模型权重该换量化版本,还是浏览器开了太多标签页。对只想确认「是不是显卡真的不够用」的人来说,这已经省下大半个下午;但对想要一键释放显存的人来说,它并不提供那个按钮。
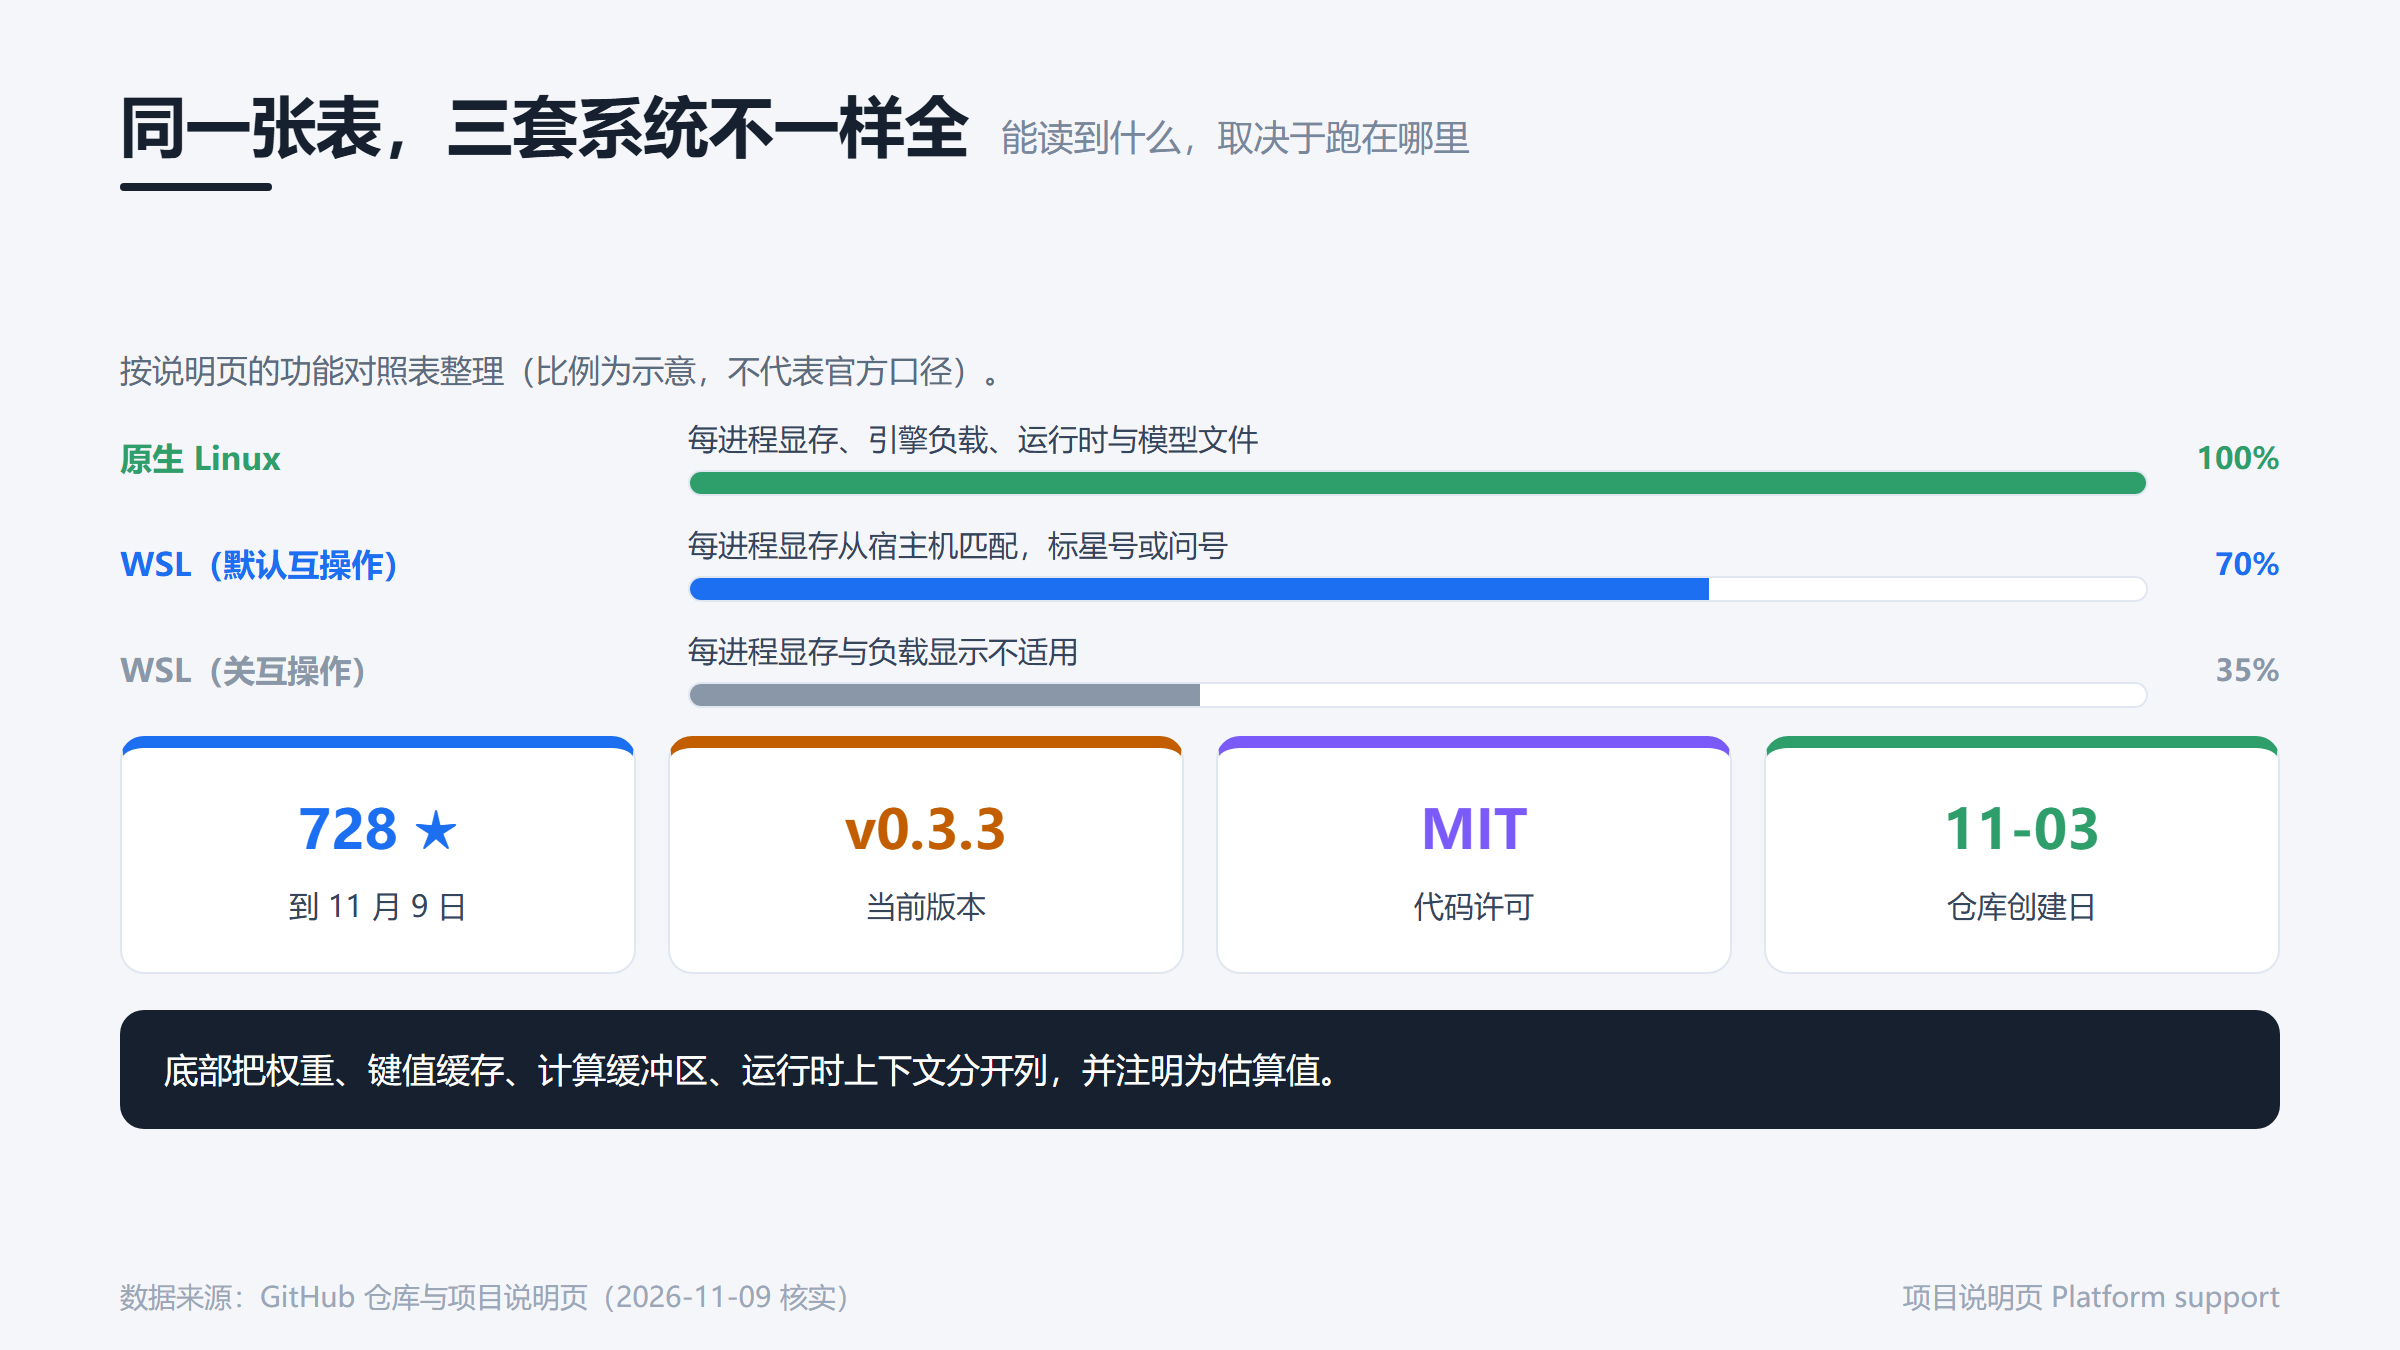
三套系统的可读数据与显存构成拆解,数据来自项目说明页
有个细节挺克制:底部会把权重、键值缓存、计算缓冲区、运行时上下文分开列,并注明这些是「分配尺寸来自日志」的估算值。把估算和实测分两行写,比混成一个总数更经得起追问。
你查显存时最想知道的是哪个进程在占、占的是权重还是缓存,还是为什么跑到了系统内存里?