看到一条节奏很顺的短片,想照着做一条,第一步就卡住了:哪些是实拍,哪些是生成的,动效是剪出来的还是代码写的?逐帧拖进度条能数出切点,却说不清机位、布光、字幕入场时间;照着感觉模仿,成片总差一口气。更难的是混合型内容——人物是生成的、界面是代码画的、中间还夹着一段屏幕录制,靠肉眼很难把边界分清楚。
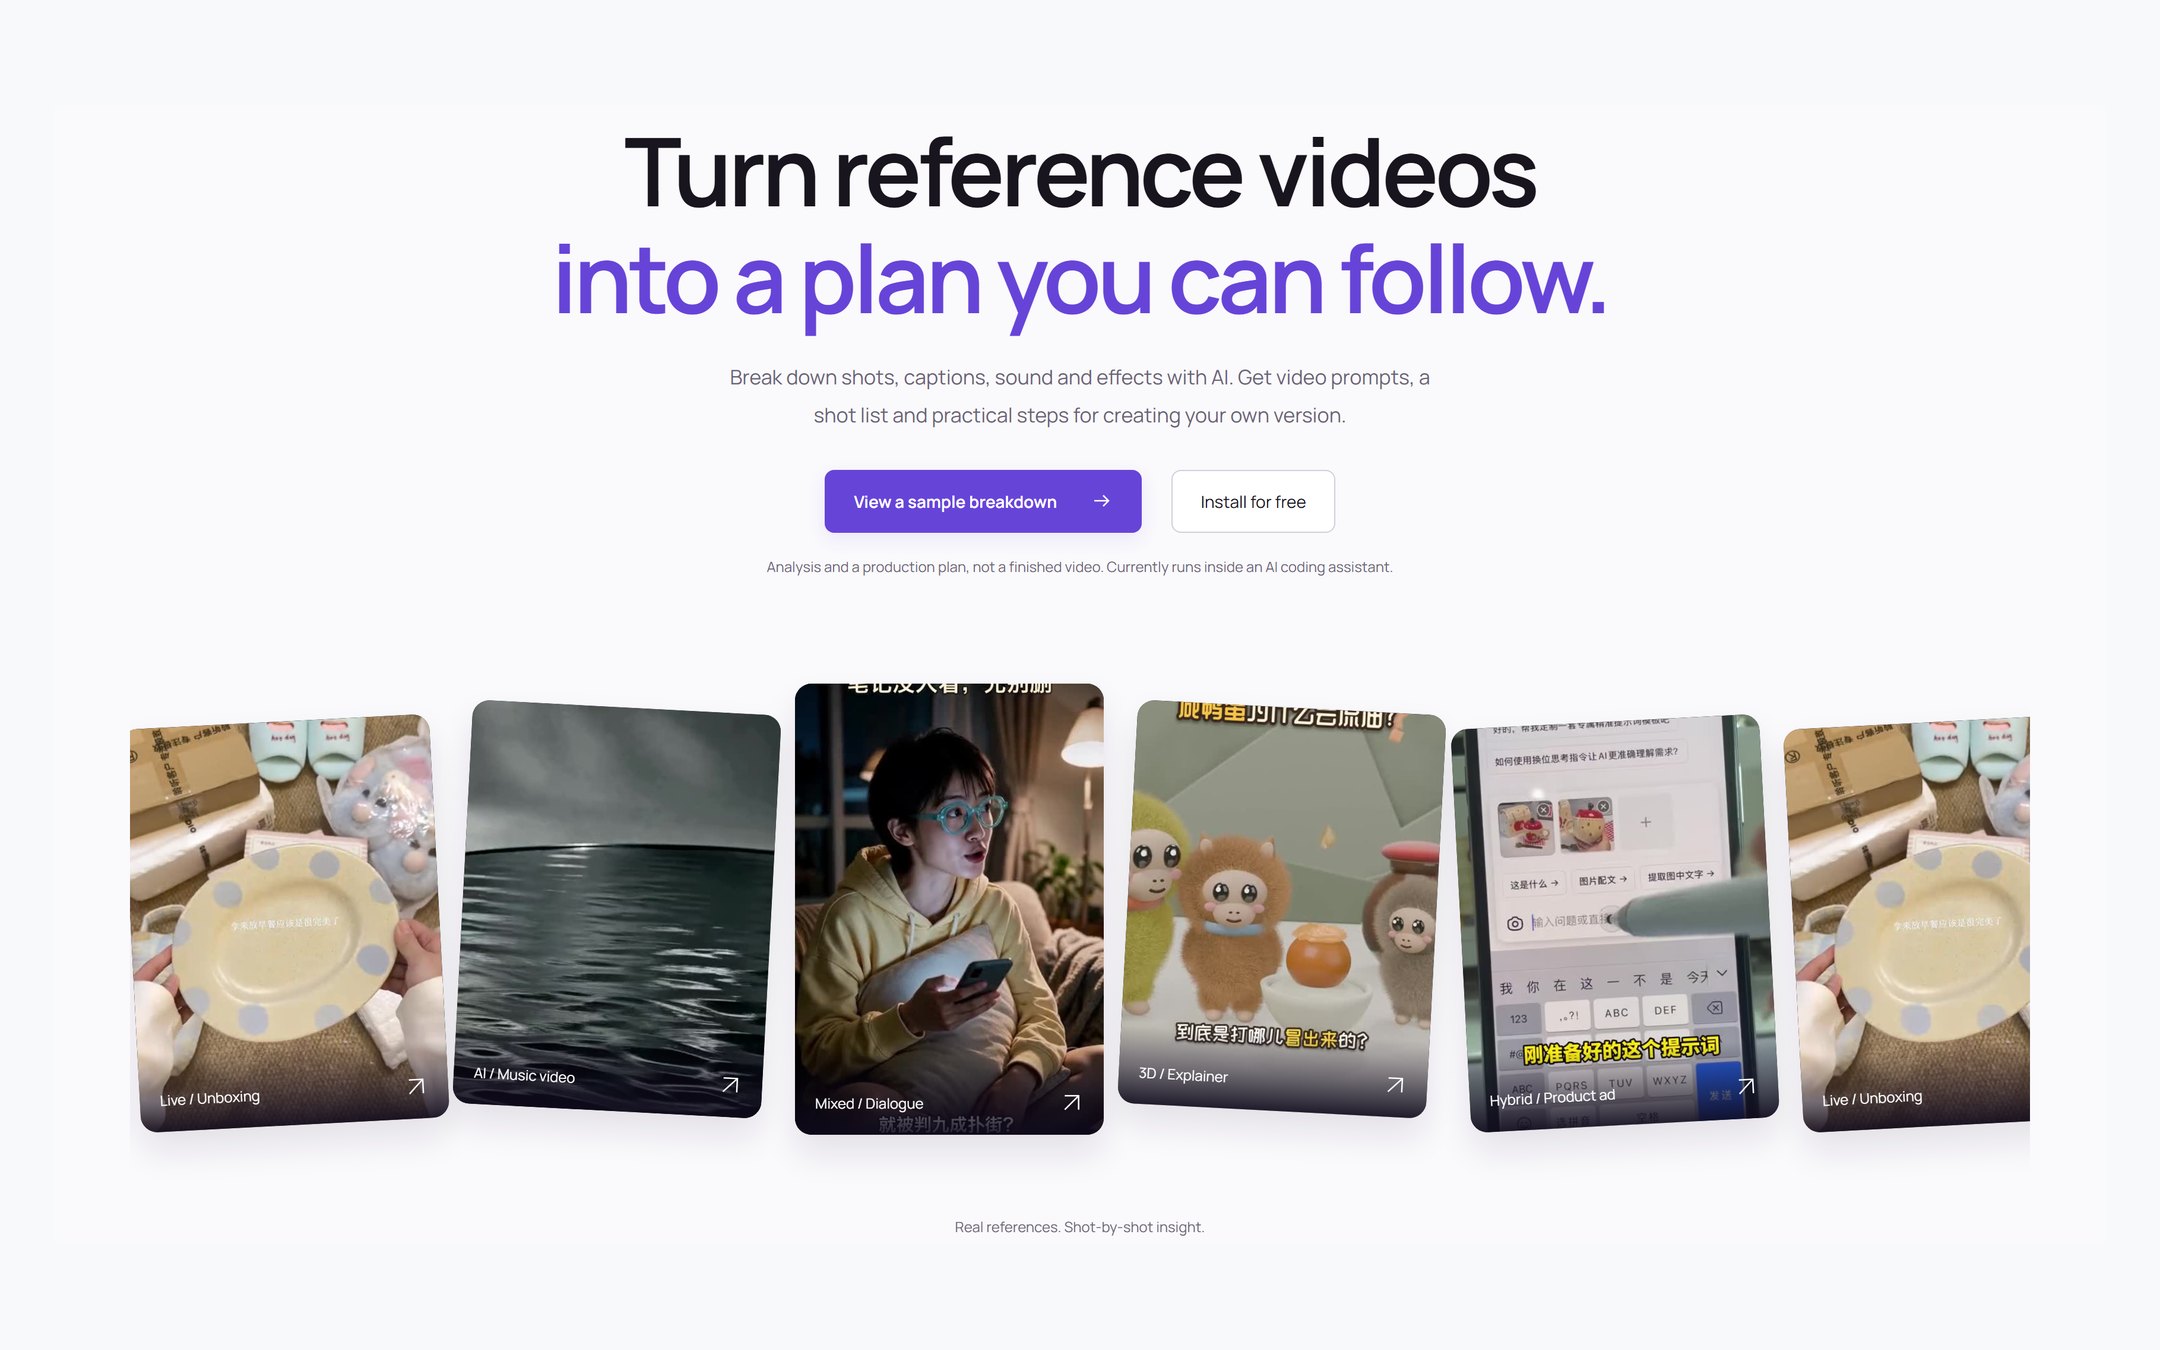
rea-video 官网首页,一句话说明「看懂视频,再学会做出来」
rea-video 是 10 月 29 日新建的开源仓库,到 11 月 9 日攒了 4160 颗星,Python 编写,采用 Apache-2.0 许可。它的定位是给智能体用的视频拆解助手:在能跑命令的编码环境里说一句「装好它,然后拆这条片子」,智能体会自己安装命令行工具、学会流程、把整条链路跑完。本机需要准备的是视频处理工具与 Python 3.10 以上版本。产出分三块:一行概括,比如「41% 生成画面 + 59% 代码界面,含 8 秒真实录屏,配乐 122 BPM」;一份复刻计划,把要拍、要生成、要写代码的部分分开;以及一份完整报告,逐镜头附画面帧、判断依据、可复用的提示词、机位与灯光笔记、音频拆解。
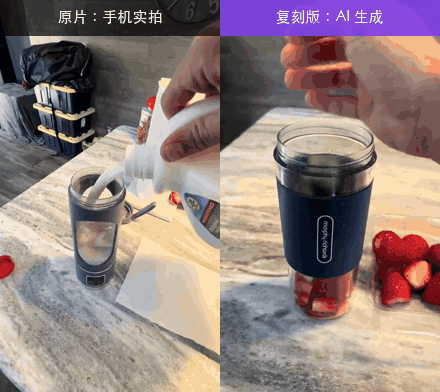
同一商品的实拍画面与生成复刻版并排,顶部标出两种来源
能拆的类型列得很细:实拍给机位、构图、运镜、灯光与调色,其中布光方案带器材清单;生成画面给每个镜头的判断依据与反推提示词,并说明怎么批量生成、适合用哪类模型;数字人镜头标出需要准备的肖像与音频;三维与动画内容判断该用生成模型还是用代码渲染;代码型动效给出文字、布局与动效时序,可以直接重建成一个可编辑工程;屏幕录制单独标出哪些素材得自己补;混合内容则先逐镜头判定,再按原时间线拼回去。
第一,它把「字幕与声音」也当成拆解对象,这点最容易被忽略。花字每行的起止时间能导出成字幕文件,颜色、描边、入场方式一并记录;贴纸、表情、画中画各自的位置与停留时长写进报告;剪辑切点在哪、切换多快、是否踩在节拍上都有标注;音频区分人声与合成配音、判断配乐来源并给出速度,音效落点也逐条列。对做短片的人来说,这些恰恰是「看着差不多、做出来差很多」的部分。
第二,报告是按可复用的方式组织的,不是一段读后感。示例里有一部 19 秒、10 镜头的混合片:人物对话由生成画面构成,界面是代码画的,中间夹着 8 秒真实录屏,报告指出五段对话虽然被界面镜头打断,但共用一套布景,一次生成就能覆盖;还有一条 67 秒、21 镜头的科普片,全片三维画面加合成旁白,报告给出两条路——十次视频生成,或让语言模型直接写三维代码。判断之后紧跟着「怎么重做」,这是它和普通画面分析最不一样的地方。
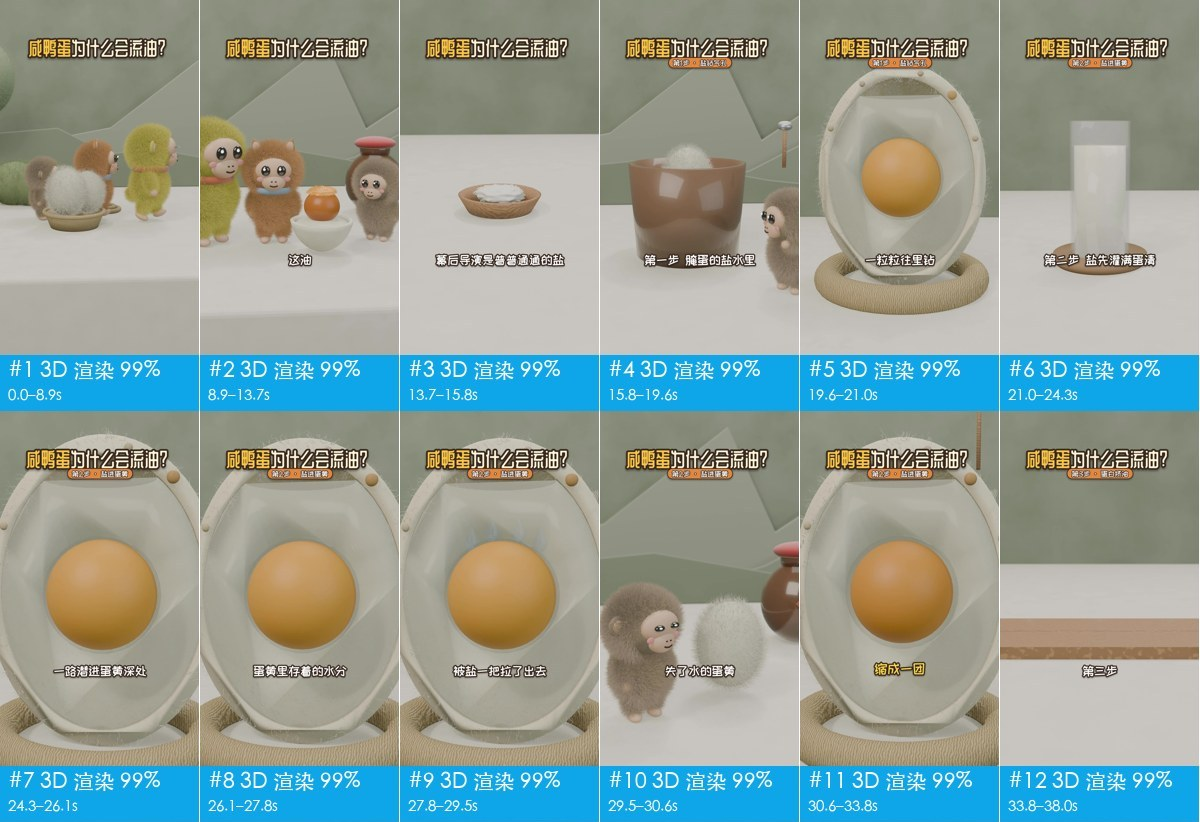
一段三维科普片的分镜表,每个镜头标出来源类型与时间段
第三,门槛和误差都要先说清。它不是装完就有窗口的软件,得有能跑命令的智能体环境,还要自备视频处理工具;接一个能看画面的模型,判定会更准、每镜头还能补出反推提示词,不接也能跑,只是拿不准的片段要靠环境自己复核。官方还提醒,仓库里的示例视频为压缩体积重新编码过,抹掉了原始来源标记,自己拿同一段素材跑,结果未必与示例报告完全一致。想直接得出「一键成片」的结论,会失望;想拿到一份逐镜头的施工说明,它给得挺全。
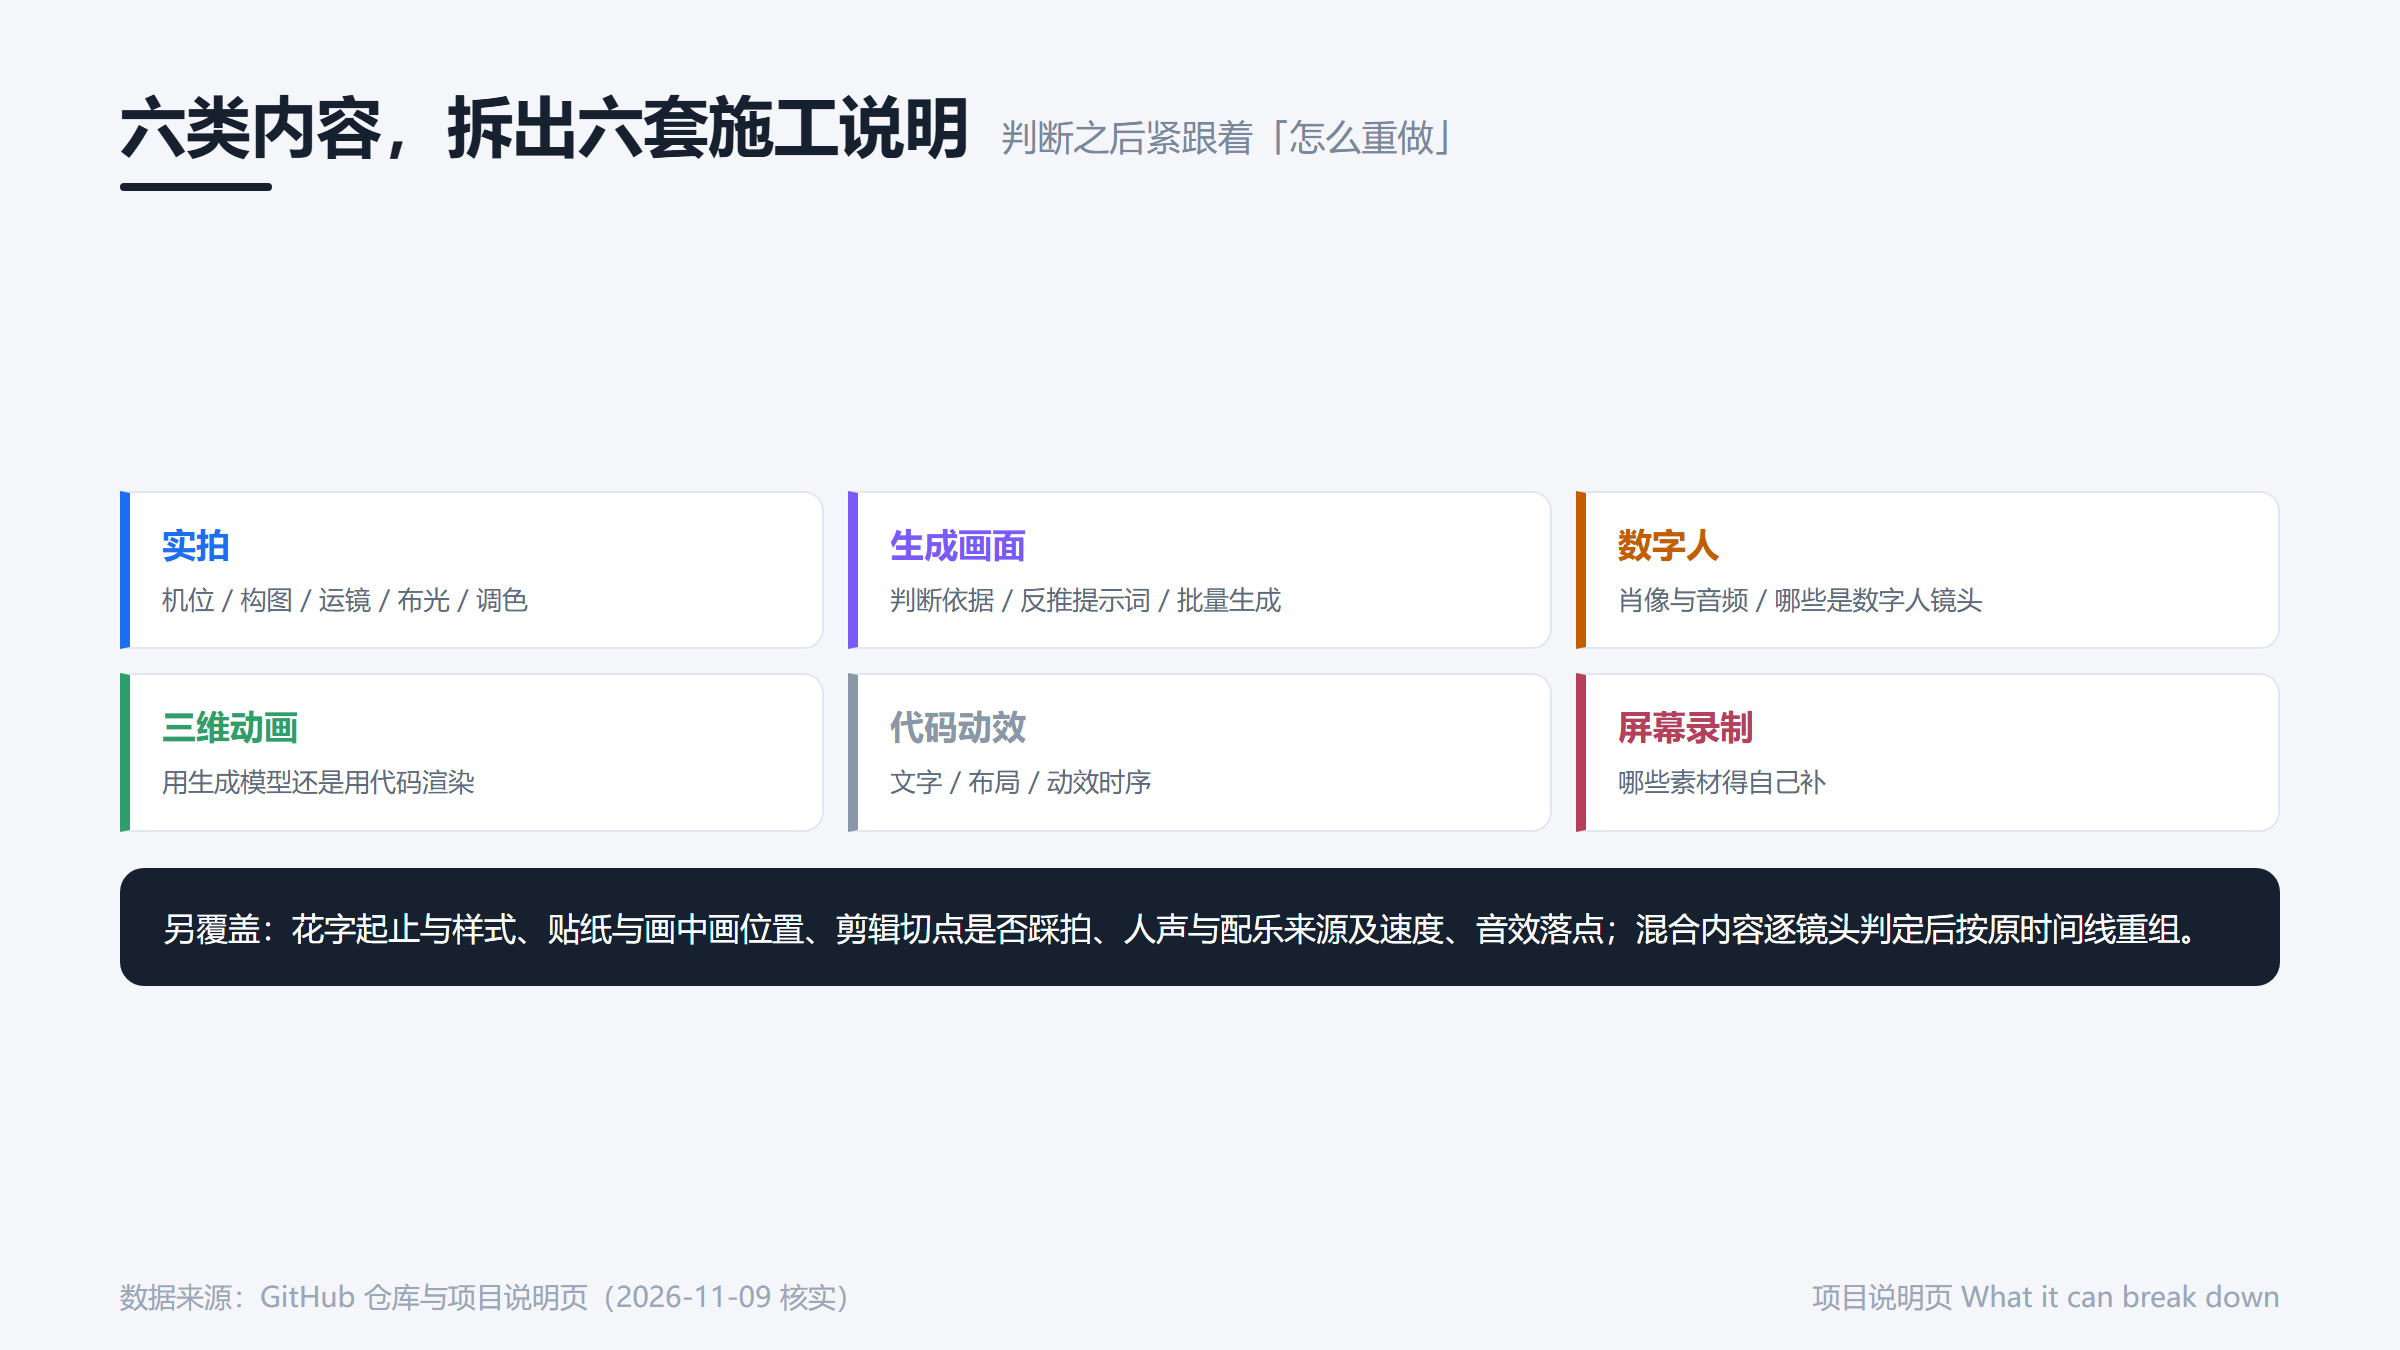
六类视频的拆解产出与复刻路线,数据来自项目说明页
有个细节挺克制:报告会明确列出需要你自己提供的素材,比如屏幕录制、界面截图、产品照片。它不假装能把缺的东西变出来,只把「哪一段该由你补」写清楚。
你拆一条片子时最想先弄清的是镜头怎么拍、字幕动效怎么做,还是配乐与切点怎么卡?