想做一段歌声,过去的路子无非两条:找真人录采样,或者用神经网络模型生成。前者要素材、有版权麻烦,后者要算力、还得调参。最近有个开源项目选了第三条路——不采样、不用神经音频,纯靠模拟人的发声器官,把声音“算”出来,而且就跑在浏览器里。它叫 Chimera,到 11 月 19 日在代码托管平台上拿到 2780 颗星,MIT 许可。我把它拆开说说这条路走不走得通。
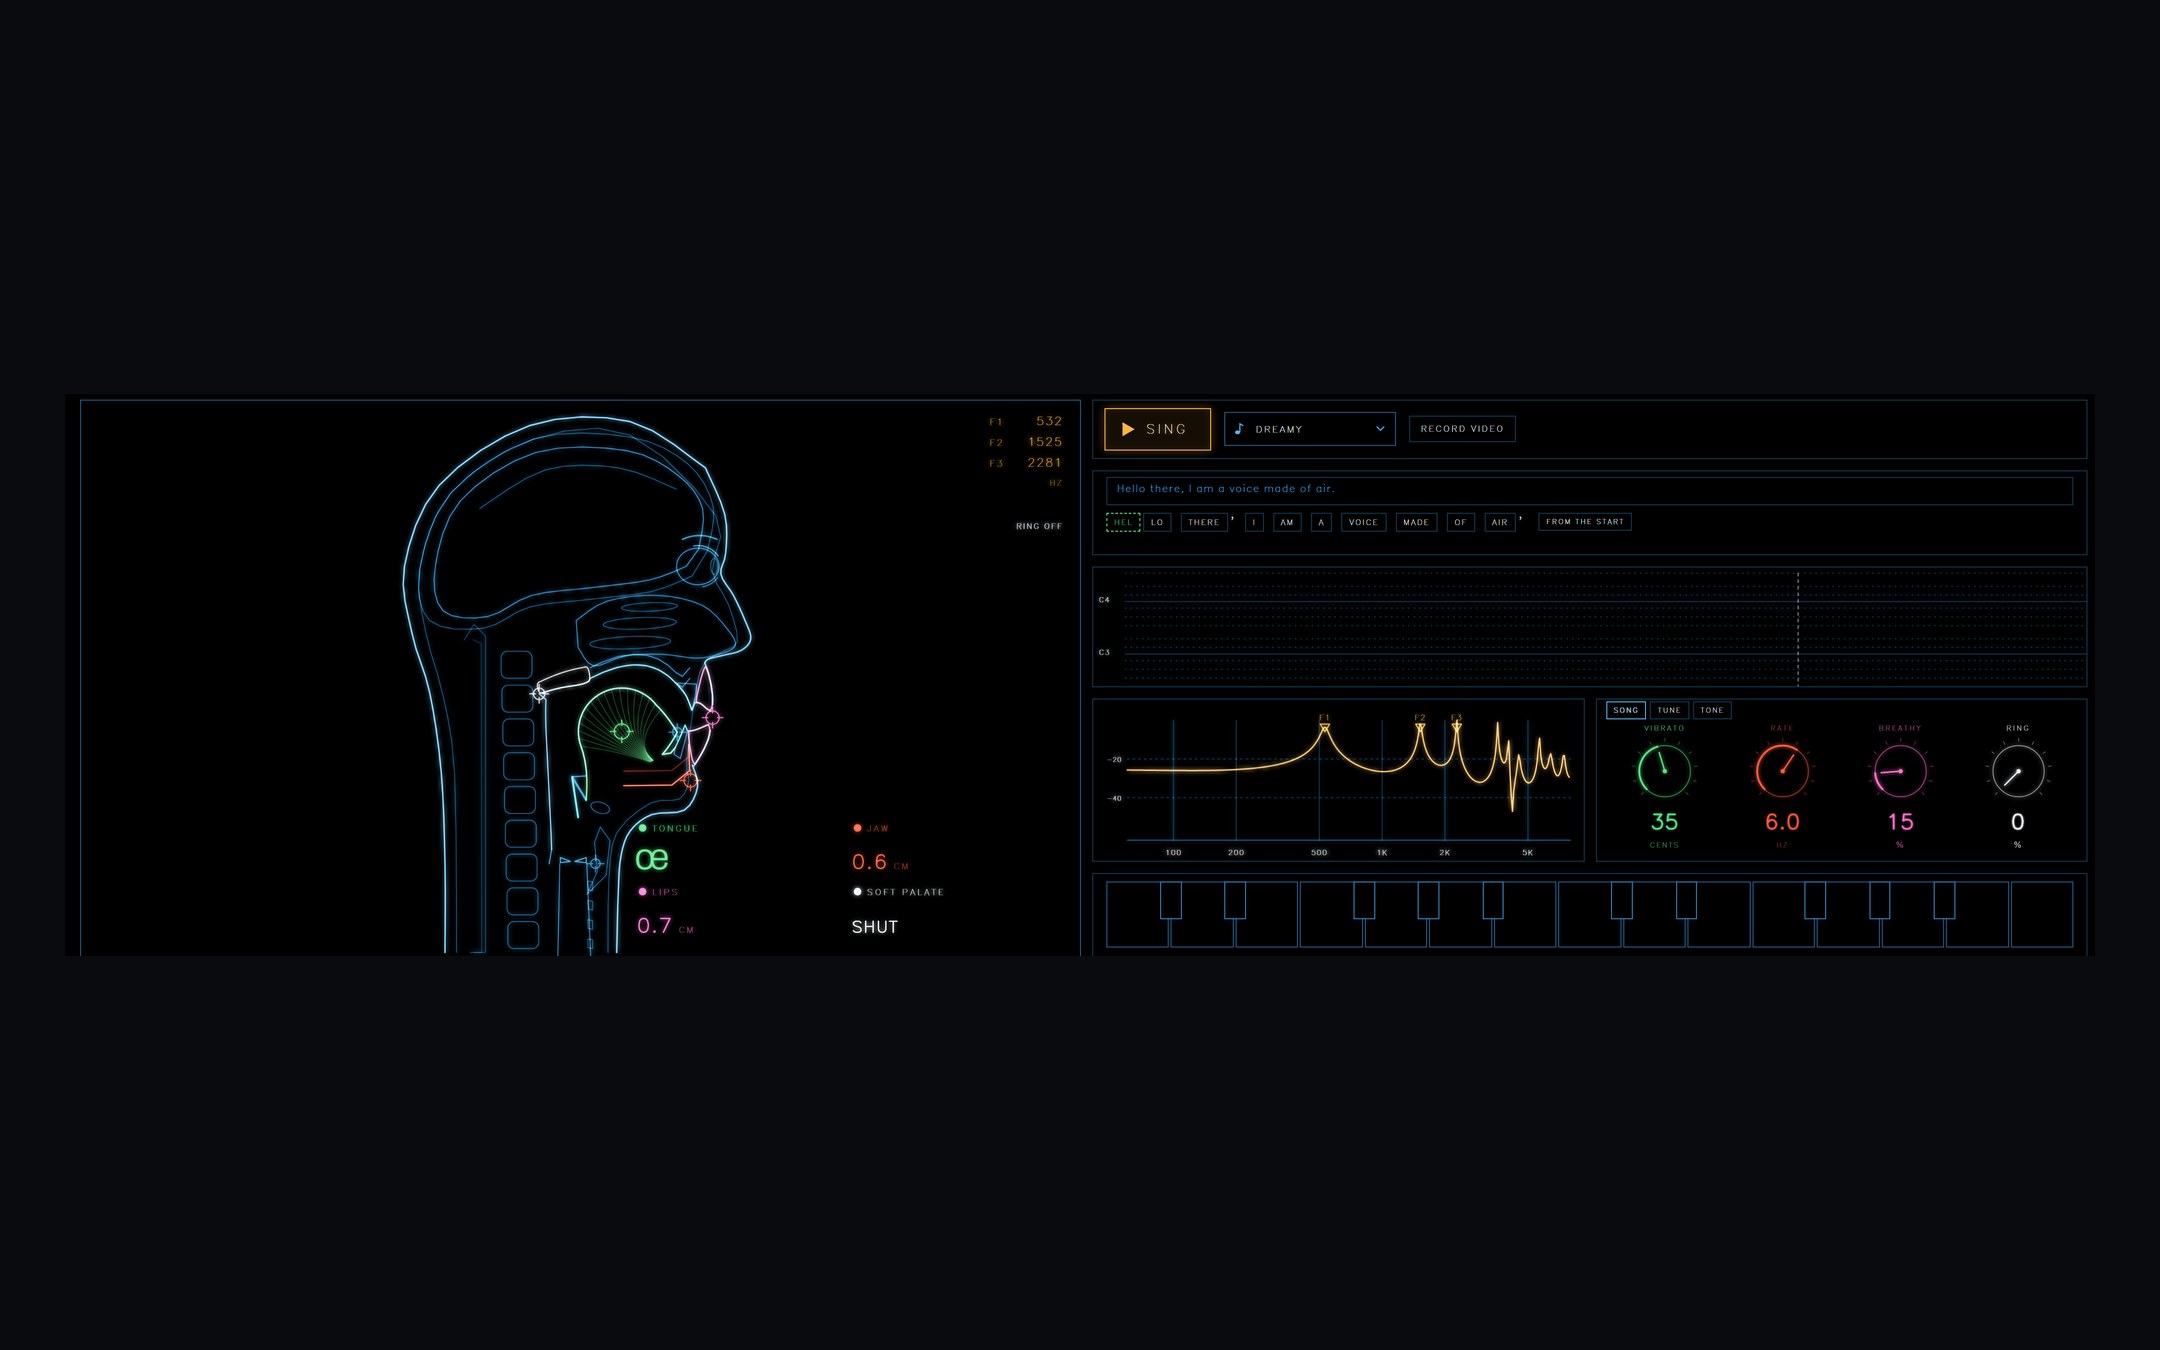
Chimera 浏览器界面,左侧是头部剖面与发声器官,右侧是合成控制区
先看它到底是什么。Chimera 是一个物理建模的歌声合成器,跑在浏览器里。它的每一个声音都来自一个被模拟的气道——肺、声带(或鸟类的鸣管)、分叉的声道、嘴唇和鼻子,而不是任何预先录好的采样。引擎用 Rust 写成,编译成网页可用的模块跑在音频线程里,同一套代码也能在本地做测试和命令行渲染。它想做成一个“乐器”:打开网页就能让人唱歌,不需要懂复杂的建模知识。一句话概括,它是在用代码造一副能说能唱的嗓子,而不是在播放别人的录音。
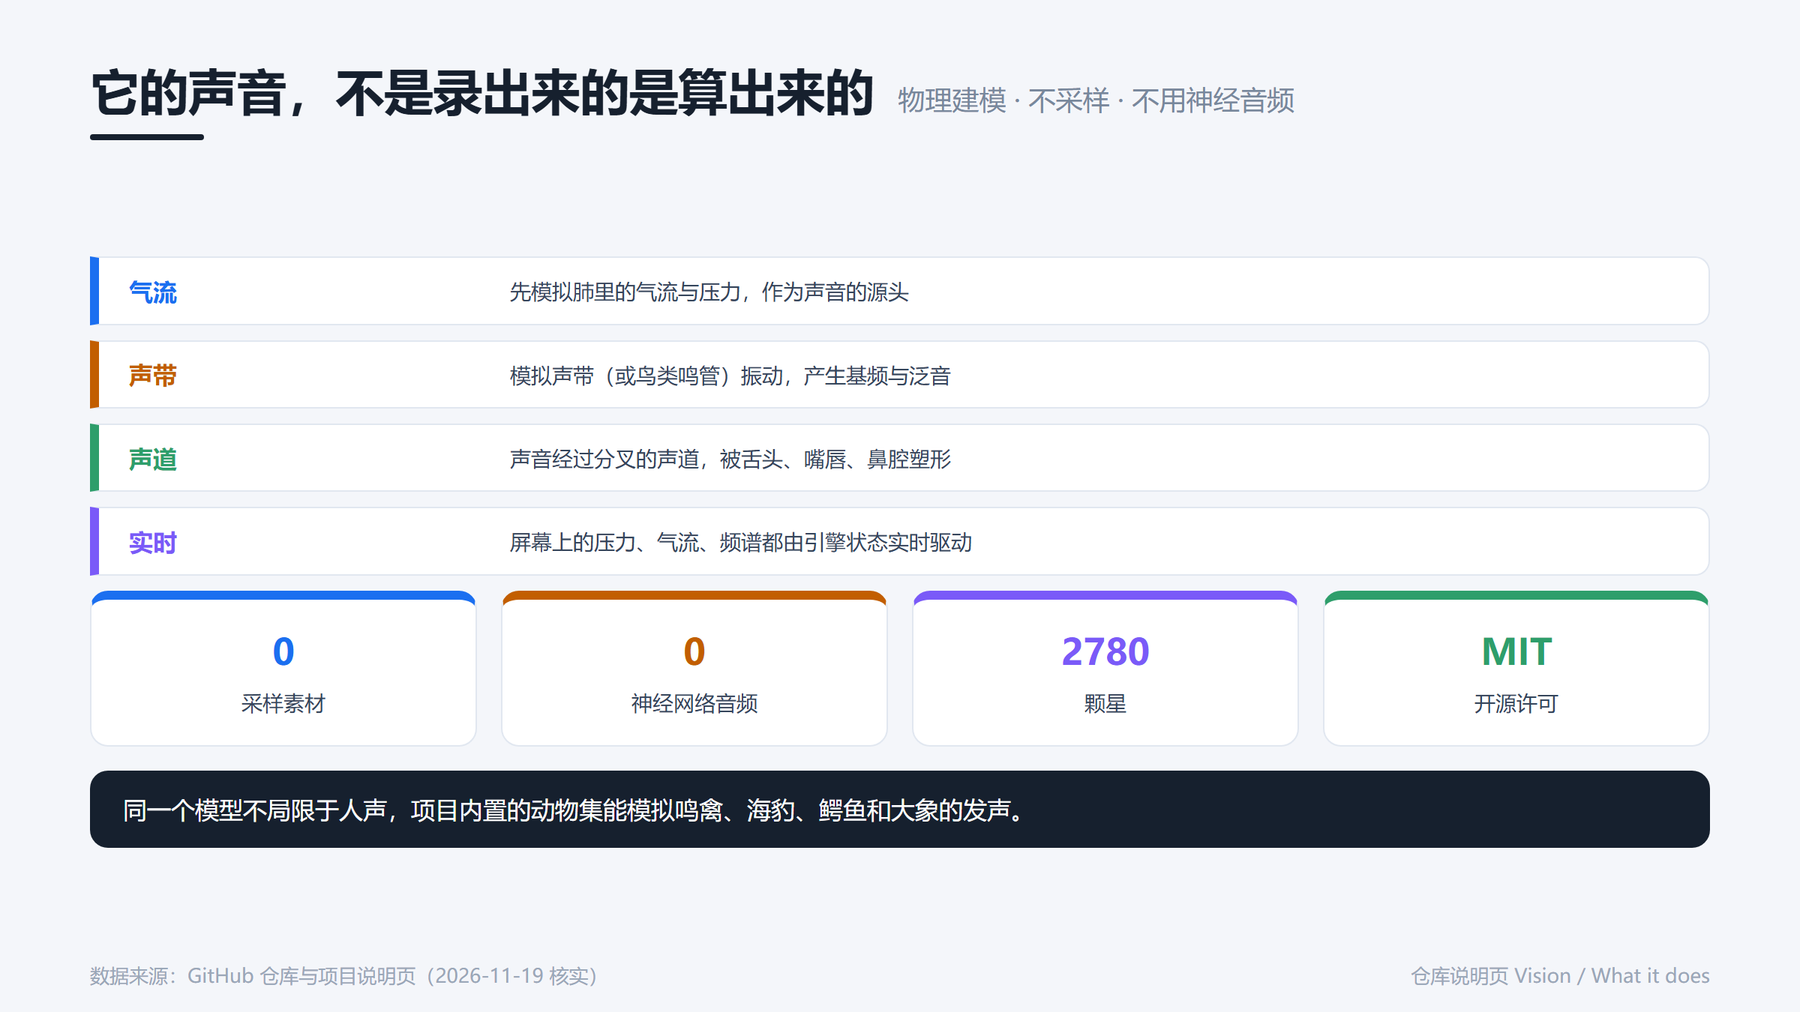
一张图看懂 Chimera 的声音从哪来——模拟气道而非采样拼接
第一,它最不一样的地方,是“声音从哪来”。传统语音合成要么拼接真人采样,要么让神经网络直接生成波形;Chimera 用的是物理模型:模拟气流从肺部上来、经过声带振动、再通过声道和嘴唇成型。界面左侧是一个头部剖面图,你可以直接拖动舌头、嘴唇和下颌的位置,元音垫、旋钮、电脑键盘甚至音乐设备接口都能演奏。屏幕上显示的气道压力、气流、声带状态和频谱,全部由引擎的实时状态驱动。男声、女声、童声的声体可以连续混合。它甚至内置了一个“动物集”:能模拟鸣禽、海豹、鳄鱼和大象的发声——因为这套模型本来就不局限于人声。
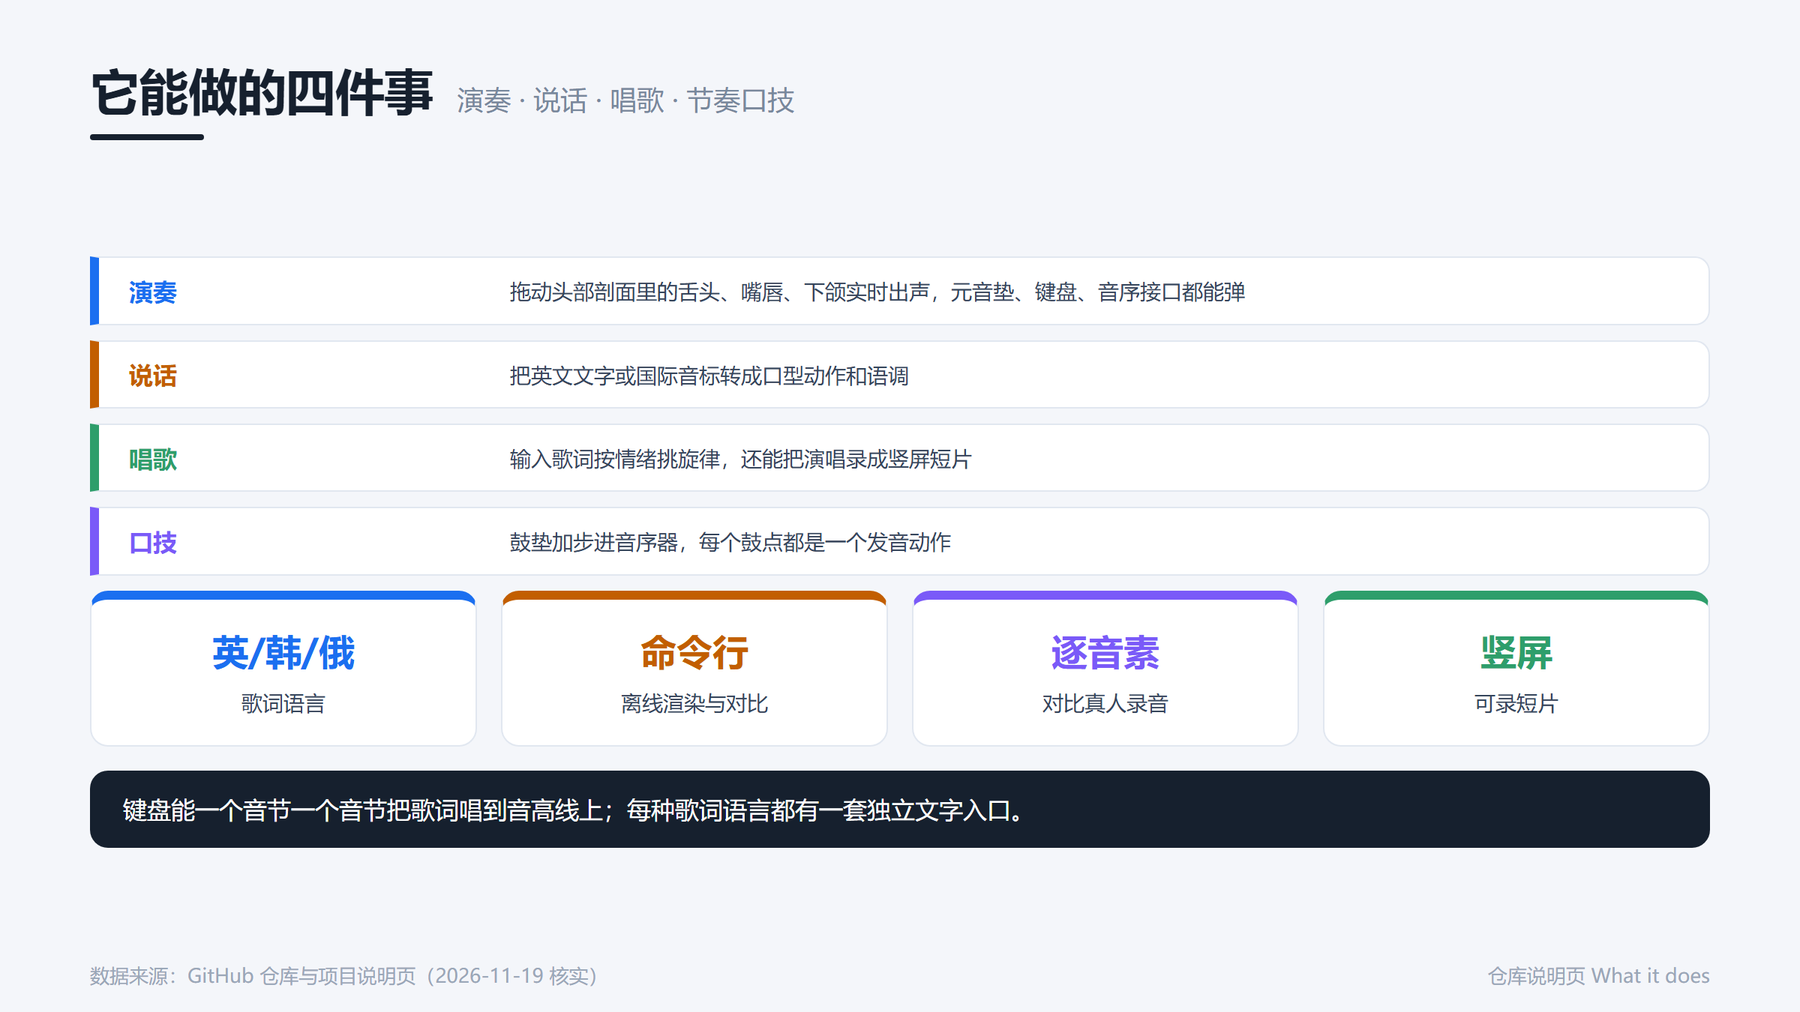
Chimera 能做的四件事:演奏、说话、唱歌、节奏口技
第二,它不只是“唱歌”这么单一。项目列了四件核心的事:一是演奏,拖动发音器官实时出声;二是说话,把英文文字或国际音标转成口型动作和语调;三是唱歌,输入歌词,它会按情绪挑一段旋律,还能把演唱过程录成竖屏短片;四是节奏口技,用鼓垫和步进音序器,每个鼓点都是一个发音动作。歌词支持英文、韩文和俄文,各有一套独立的文字入口;键盘可以一个音节一个音节地把歌词唱到音高线上。它还提供了命令行工具,能离线渲染语音、唱歌、口技,甚至能和真人歌手、真人说话录音做逐音素对比——这说明项目方是认真在追“像不像真人”这件事。
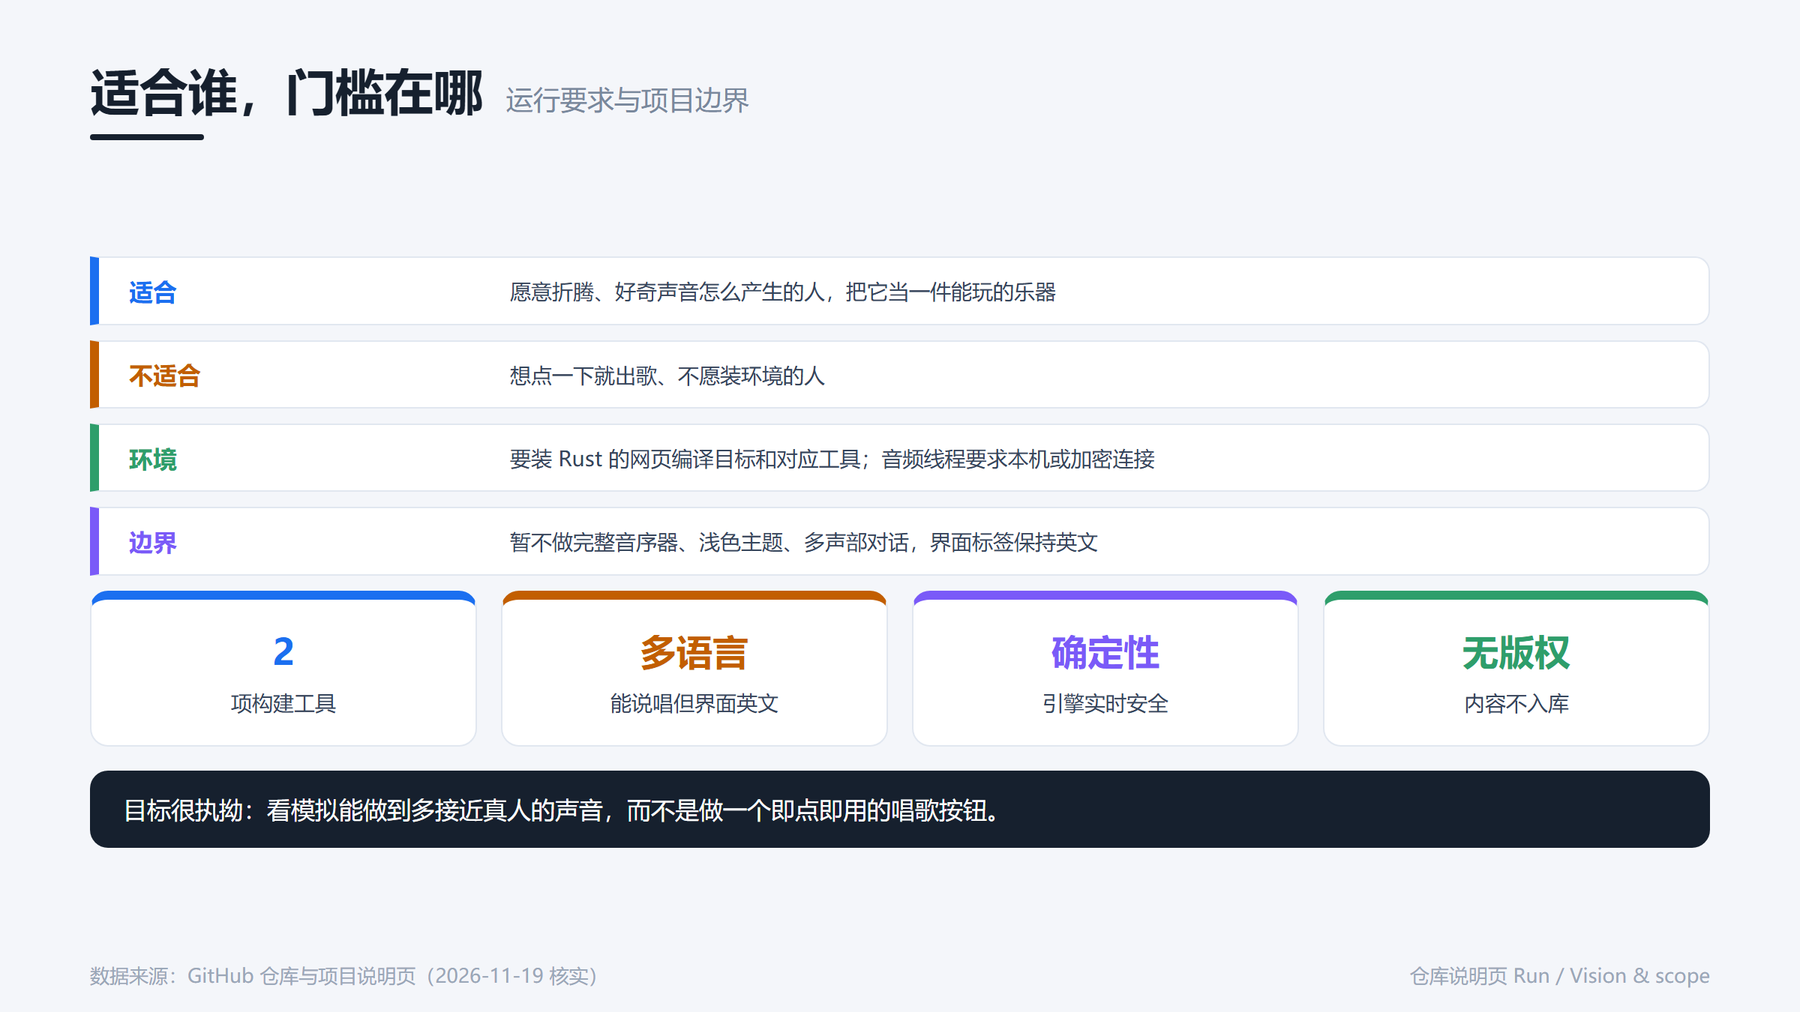
Chimera 适合谁、门槛在哪、边界如何一图看懂
第三,门槛和边界得先讲清楚,免得踩坑。要自己跑起来,需要装 Rust 的网页编译目标和 Bun 这套工具;音频线程要求安全环境,得用本机地址或加密连接打开。项目方明确写了“现在不做”的清单:不做完整的音乐制作工作站和音序器、不做浅色主题、不做多声部对话、不翻译界面——声音能说唱多种语言,但界面标签保持英文。它还特别强调两点:不把有版权的内容放进代码库,引擎是确定性的、能实时运行。所以更准确地说,这是一个给愿意折腾、又好奇“声音到底是怎么产生的”的人准备的乐器,而不是一个点一下就出歌的玩具。它的目标很执拗:看模拟能做到多接近真人的声音。
一句话收尾:把声音交还给物理规律,而不是交给采样库,是一条更少人走、但很有意思的路。如果不用任何真人录音,也能在浏览器里唱出一段像样的歌,你会想拿它来做什么?评论区聊聊你的第一个念头。