你让 AI 助手改一个函数,它先去读了二十来个文件,等它读完,上下文也差不多满了。仓库问答这件事,卡了两年,卡的就是这个:文件太多、关系太散、每次都要从头读一遍。
Graphify 想换个做法。它不在每次提问时重新读文件,而是先把整个目录编译成一张知识图谱,之后所有查询都在这张图上跑。
是什么
Graphify 是一个跑在 Claude Code 里的开源技能。装完之后,在任意目录敲一个命令:
/graphify .
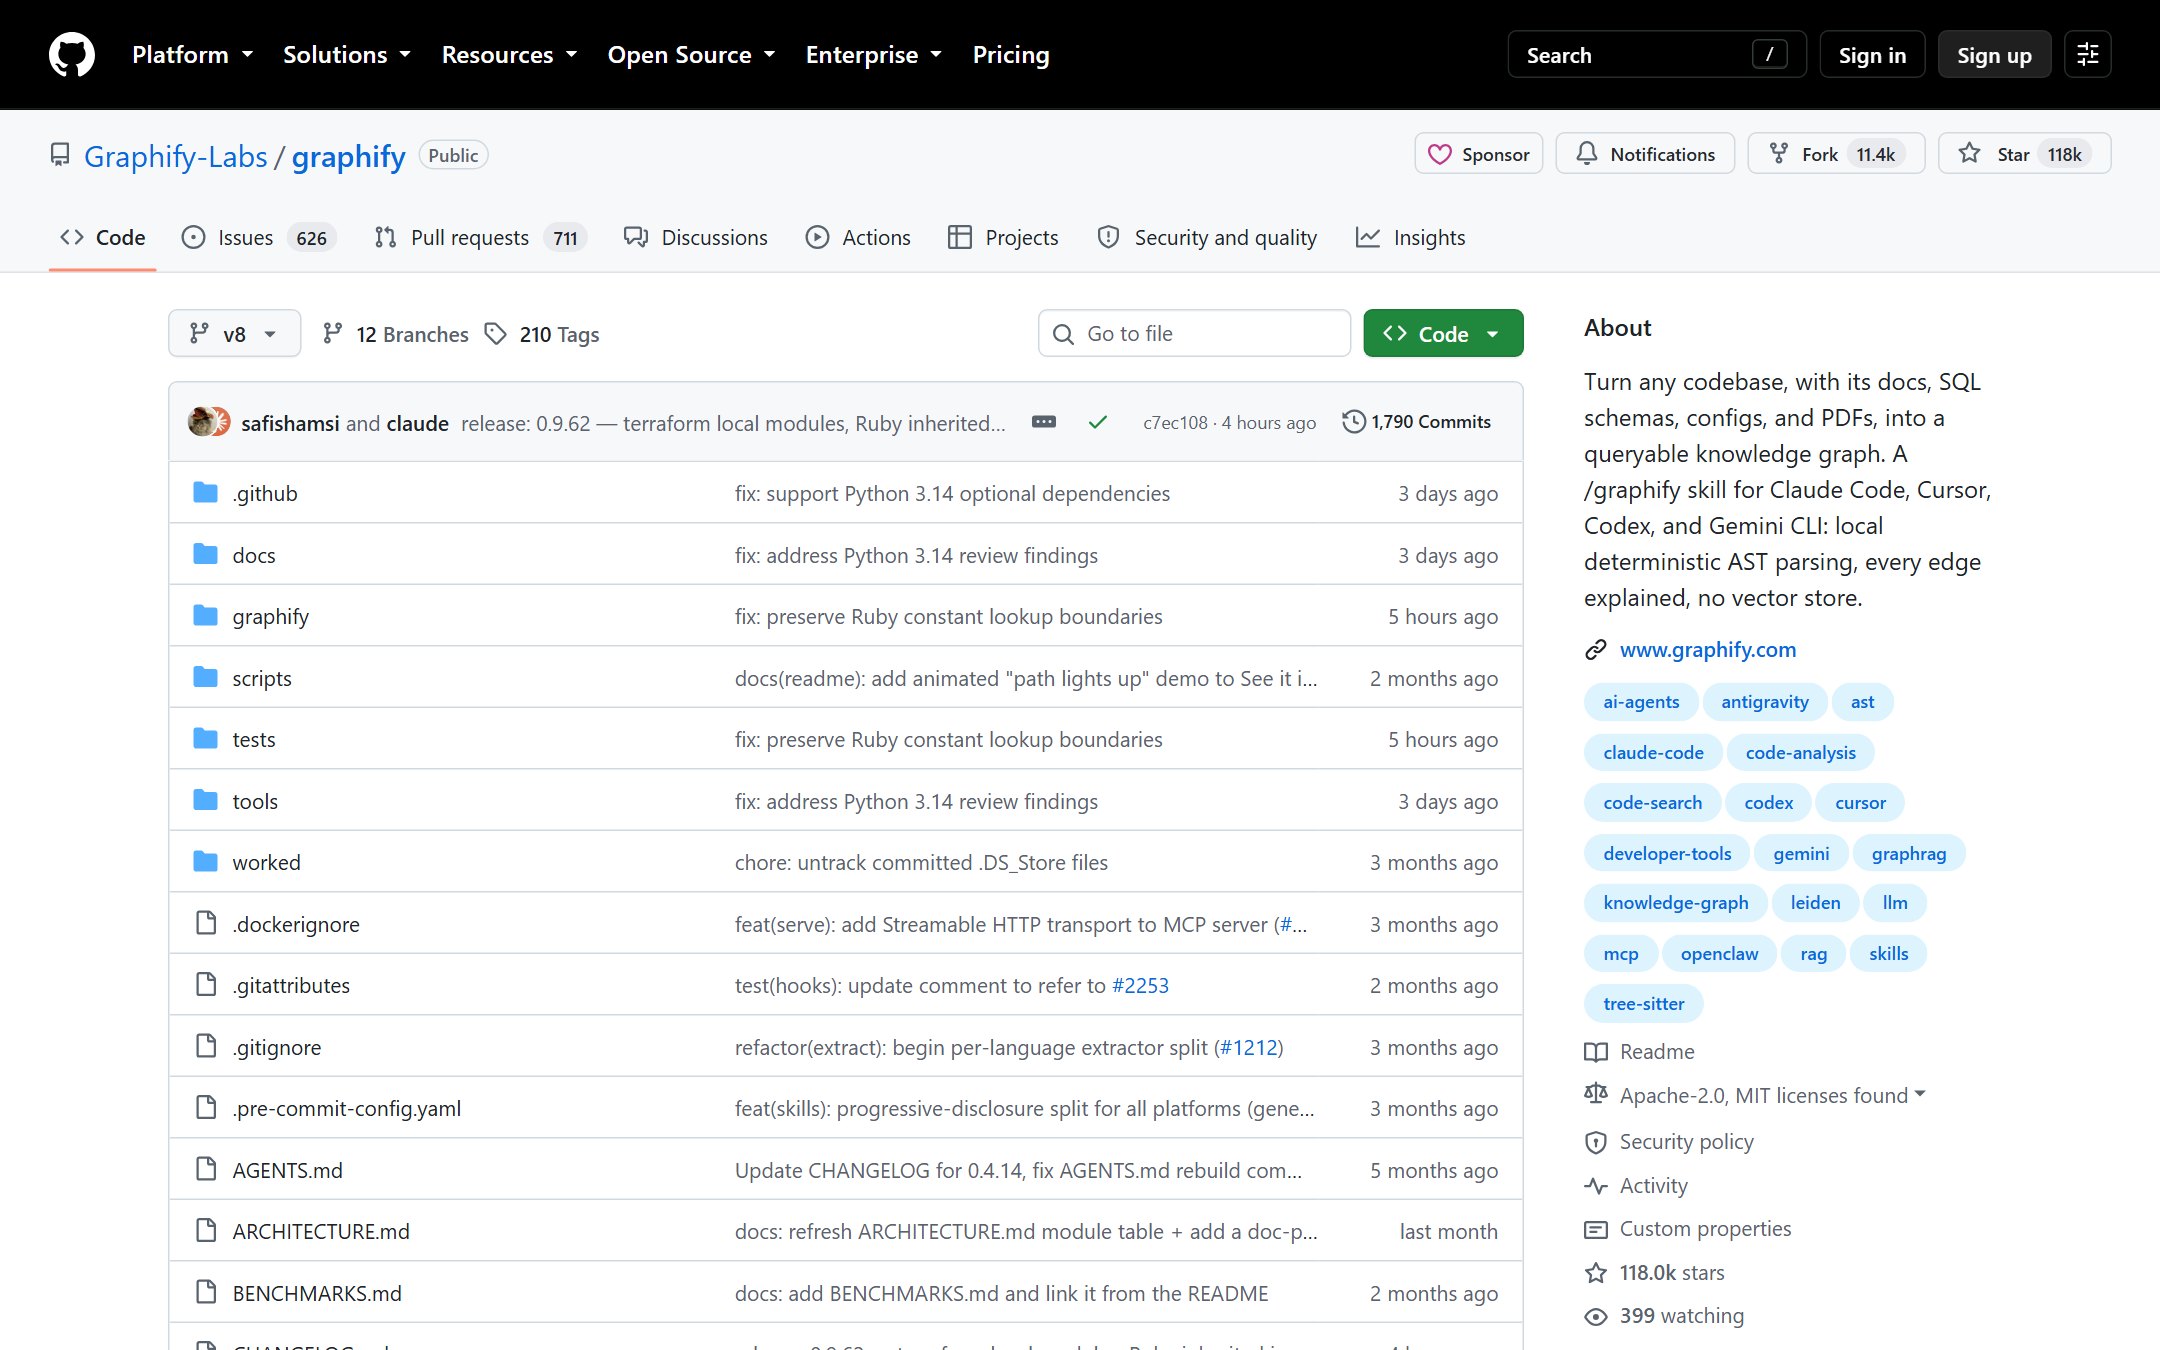
它会读完这个目录里的所有东西,建一张知识图谱,然后把结构还给你。项目在 GitHub 上已经拿到 11.8 万 Star,1.14 万 Fork,Apache-2.0 协议,最新版本 v0.9.62(2026-09-15 发布),从 2026 年 4 月建仓到现在,仓库几乎每天都在提交。
它吃的东西比一般的代码索引工具杂得多:.py .ts .js .go .rs .java .c .cpp .rb .cs .kt .scala .php 走 tree-sitter 的 AST 解析,Markdown 和 txt 提概念与关系,PDF 做引用挖掘,连 PNG、JPG 截图和示意图也收。白板上随手拍的那张照片它也能读,而且不限语言。
核心优势
Token 压缩是它最硬的一个数字。作者拿一个混合语料做了实测:Karpathy 的几个仓库,加上 5 篇论文、4 张图片,一共 52 个文件。同样的查询,走图谱比直接读原始文件省 71.5 倍 Token。语料缩小到 4 个文件(graphify 自己的源码加一篇 Transformer 论文),倍数是 5.4 倍;再缩小到 6 个文件的 httpx 示例,就几乎是 1 倍了。这个规律很诚实:文件少的时候图的价值是结构清晰,不是省 Token;文件一多,压缩比才起飞。每个实测目录的输入文件和输出报告都放在仓库的 worked/ 下面,可以自己跑一遍验数。
每条边都标了来源。这是我觉得最有用的一处设计。图里所有的连线都被打上三个标签之一:EXTRACTED(从内容里实读出来的)、INFERRED(模型推断的)、AMBIGUOUS(拿不准的)。很多知识图谱工具最大的毛病就是把推断和事实混在一起端给你,你还以为那都是真的。Graphify 直接把这件事摆在明面上,你看到一条边就知道该不该信。
代码部分走的是本地确定性解析。代码走 tree-sitter 的语法树加一遍调用图分析,这一步不调用任何模型,也不产生费用。整套技术栈是 NetworkX 加 Leiden 社区发现、tree-sitter、vis.js,跑在你自己的电脑上。不用装 Neo4j,不用起服务,也没有向量库。
产物不止一张图。跑完一次会生成一整个 graphify-out/ 目录:graph.html 是可交互图,能点节点、搜索、按社区过滤;obsidian/ 可以直接当 Obsidian 仓库打开;wiki/ 是按社区和核心节点生成的维基式文章,带头部 index.md,可以直接指给别的 Agent 读;GRAPH_REPORT.md 里是核心节点、让人意外的连接、还有四五个这张图特别适合回答的问题;graph.json 是持久化图谱,几周之后再来查,不用重读原始文件。
增量更新是接进工作流的。--watch 开着,代码文件一保存就即时重建(只跑 AST,不调模型),文档和图片变了会提示你跑一次 --update。另一个选项是 graphify hook install,装一个 post-commit 钩子,每次提交自动重建,不需要常驻进程。多个 Agent 并行写代码的场景下,这个设计挺实用 —— 两波任务之间图始终是新的。
怎么用
前置条件是 Claude Code 加 Python 3.10 以上。装就两行:
pip install graphifyy && graphify install
注意 PyPI 上的包名暂时叫 graphifyy(多一个 y),因为原来的名字还在回收中,但命令和技能名都还是 graphify。Windows 上如果装完提示命令找不到,把 Python 的 Scripts 目录加进 PATH;macOS 如果报 externally-managed-environment,改用 pipx install graphifyy。
然后打开 Claude Code,进任意目录,敲 /graphify . 就行。其余常用命令:
/graphify ./raw --mode deep 更激进地抽推断边/graphify ./raw --update 只重抽变化的文件,合并进已有图/graphify add https://arxiv.org/abs/xxx 抓一篇论文存下来并更新图/graphify query "attention 和优化器之间是怎么连的" 直接问图/graphify path "DigestAuth" "Response" 找两个概念之间的路径/graphify explain "SwinTransformer" 解释某个节点--wiki / --svg / --graphml / --neo4j / --mcp 分别导出维基、SVG、GraphML、Neo4j 的 cypher 脚本、或起一个 MCP 服务
不是没有槽点
它绑死 Claude Code。README 里写得清清楚楚,前置条件就是 Claude Code。你要是不在这个生态里,这个工具基本用不上。对用 Codex、Gemini CLI 的人来说,这是最硬的劝退点。
省钱这件事要分开算。代码是 AST 解析,不花钱;但文档、PDF、图片的抽取是要走视觉模型的,这部分不省反而花。别看到 71.5 倍就以为所有场景都便宜。那个数字指的是「查询时你少喂多少进去」,不是「建图零成本」。
小语料没必要上。作者自己给了数:6 个文件的时候压缩比约等于 1 倍。文件少到能塞进上下文窗口,图谱的价值就只剩结构清晰。别为了用工具而用工具。
推断边需要人盯着。仓库现在有 1337 个未关闭的 issue,最近提交的一批里能看到不少边界问题:Ruby 的类型成员调用解析不到继承、增量重建在特定情况下会把节点清零、缓存会在自适应阈值下静默丢条目。标了 INFERRED 的边,尤其是跨文件的,该核还是得核。
跟同类比怎么看
和向量库 RAG 比,Graphify 的取舍很明确:它没有向量检索,所以「意思相近但用词不同」的模糊召回会弱一些;换来的是关系可追溯、每条边能解释、不用维护一套嵌入索引。一个是语义相似度,一个是结构化关系,解决的不是同一个问题。
和 GraphRAG 那一路比,它的门槛低得多,不用起数据库也不用配服务,一个 pip 装完就在本地跑。
和直接 grep、或者让 Agent 自己满仓库翻文件比,它多出来的东西是持久化:图落盘了,第二个会话、第二个 Agent 接手时不用从头再读一遍。这也是我觉得它真正解决的那个痛点。
一句话:如果你经常让 AI 碰一个几十上百文件的仓库,或者有一个越攒越大的资料夹(论文、截图、笔记混在一起那种),Graphify 值得花十分钟装一下。文件不到十个的话,先别折腾。
GitHub:https://github.com/Graphify-Labs/graphify
官方网站:https://www.graphify.com
标签:#Graphify #代码知识图谱 #AI编程 #仓库问答 #GraphRAG #开发者工具
你平时更头疼哪种情况:仓库太大 AI 读不完,还是资料太杂根本没法整理?